Rápido por dónde se ejecuta
En memoria, en proceso o a un salto de distancia — particionado para el paralelismo, con una ruta crítica de baja asignación y operaciones masivas que amortizan la red. Una caché compatible con Redis que es más rápida en nodos de producción, y búsqueda indexada que supera a una base de datos sobre un millón de registros. Y todo es medible, en vivo, desde la consola.
Velocidad por diseño, no por un truco de benchmark
El rendimiento proviene de dónde residen los datos y de cómo las solicitudes llegan a ellos — las mismas propiedades se mantienen tanto si lo ejecutas embebido como en clúster.
En memoria
Los datos residen en la RAM, no en disco. Las lecturas y escrituras nunca esperan a la E/S de almacenamiento — la durabilidad proviene de la replicación, no de fsync.
Opción en proceso
Ejecuta de forma embebida y no hay ningún salto de red — las llamadas son llamadas a métodos. El mismo código pasa a un clúster cuando lo necesites.
Paralelismo particionado
Las claves se distribuyen entre particiones y nodos, de modo que el rendimiento escala con el clúster — añade nodos y el mapa crece sobre ellos.
Ruta crítica de baja asignación
Las métricas integradas miden la ruta crítica con una asignación mínima, y el cliente agrupa las conexiones — la sobrecarga se mantiene fuera de tu presupuesto de latencia.
Operaciones masivas y por lotes
PutMany / GetMany y los lotes mixtos agrupan muchas claves en un solo viaje de ida y vuelta por propietario, amortizando el coste de red.
Replicación asíncrona
Con la replicación asíncrona una escritura se confirma sin esperar a cada réplica; elige síncrona + quórum cuando quieras garantías más estrictas.
Míralo moverse, en vivo
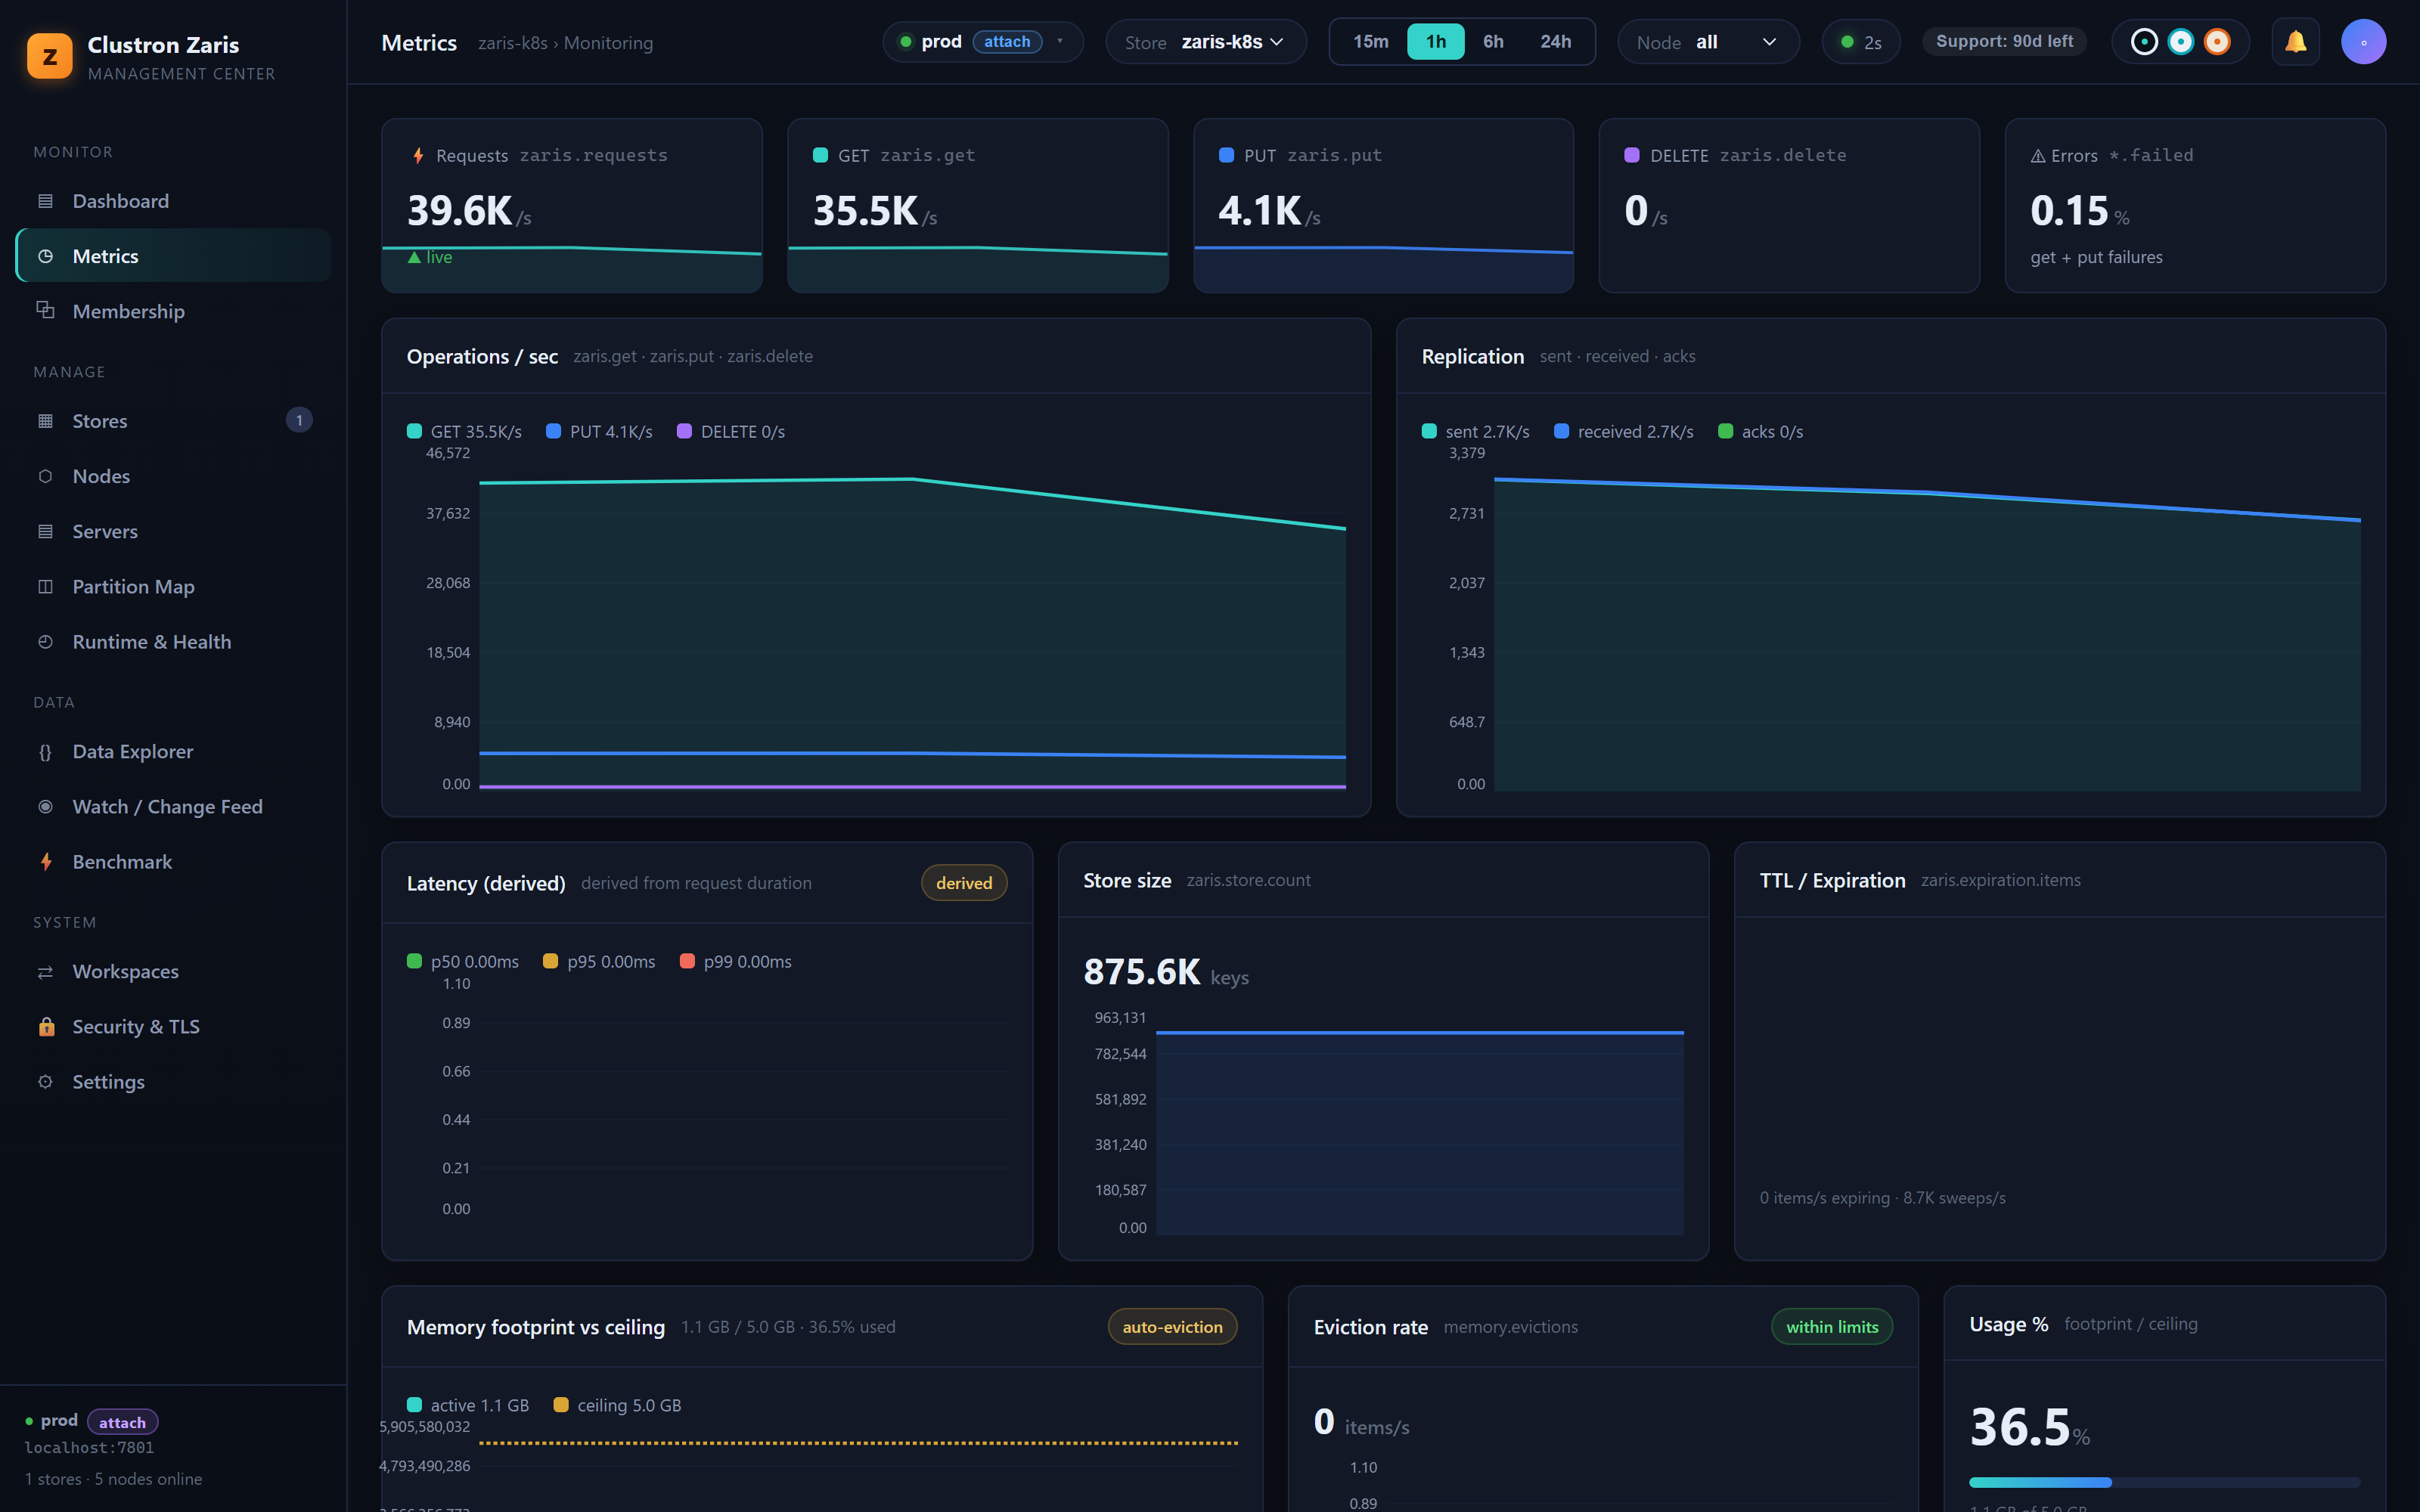
Zaris está diseñado para un rendimiento muy alto con latencia inferior al milisegundo — y las cifras escalan con tu hardware, así que las que importan son las tuyas. La consola transmite rendimiento, replicación y latencia en tiempo real, y el benchmark integrado te permite medirlo en tu propio clúster.
- Ops/seg en vivo, replicación y latencia derivada en la consola
- Benchmark integrado para probar la carga de tu clúster real
- Exporta todo por OTLP a la pila que ya utilizas
Equilibra latencia y durabilidad, por almacén
El mismo almacén puede favorecer la velocidad bruta o garantías más estrictas — los ajustes son configuración, no una reescritura.
Modo de replicación
Asíncrona para la menor latencia de escritura; Síncrona con un quórum (All / Majority) cuando una escritura debe ser durable en las réplicas antes de retornar.
Factor de replicación
Un RF más alto significa más disponibilidad pero más trabajo de replicación por escritura. RF2 tolera la pérdida de un nodo; elígelo por almacén.
Conexiones de cliente y conmutación por error
El cliente agrupa las conexiones y conmuta por error a través de la lista de semillas, luego enruta cada clave directamente a su propietario — sin salto de proxy.
TTL y desalojo
La memoria acotada con TTL y desalojo bajo un límite mantiene el conjunto de trabajo activo sin crecimiento ilimitado.
Míralo moverse — en tu propio clúster
Levanta un almacén, ejecuta el benchmark integrado y observa las cifras en vivo. Luego ajústalo a tu carga de trabajo.