Rapide grâce à l'endroit où il s'exécute
En mémoire, en processus ou à un saut de distance — partitionné pour le parallélisme, avec un chemin critique à faible allocation et des opérations en masse qui amortissent le réseau. Un cache compatible Redis plus rapide sur des nœuds de production, et une recherche indexée qui bat une base de données sur un million d'enregistrements. Et tout est mesurable, en direct, depuis la console.
La vitesse vient de la conception, pas d'une astuce de benchmark
La performance vient de l'endroit où se trouvent les données et de la façon dont les requêtes les atteignent — les mêmes propriétés tiennent que vous exécutiez en embarqué ou en cluster.
En mémoire
Les données résident dans la RAM, pas sur le disque. Les lectures et écritures n'attendent jamais les E/S de stockage — la durabilité vient de la réplication, pas du fsync.
Option en processus
Exécutez-le embarqué et il n'y a aucun saut réseau — les appels sont des appels de méthode. Le même code passe à un cluster lorsque vous en avez besoin.
Parallélisme partitionné
Les clés sont réparties entre les partitions et les nœuds, de sorte que le débit monte en charge avec le cluster — ajoutez des nœuds, la carte s'étend sur eux.
Chemin critique à faible allocation
Les métriques intégrées mesurent le chemin critique avec une allocation minimale, et le client met en pool les connexions — la surcharge reste hors de votre budget de latence.
Opérations en masse et par lots
PutMany / GetMany et les lots mixtes regroupent de nombreuses clés en un seul aller-retour par propriétaire, amortissant le coût réseau.
Réplication asynchrone
Avec la réplication asynchrone, une écriture est acquittée sans attendre chaque réplica ; choisissez sync + quorum lorsque vous voulez des garanties plus fortes.
Voyez-le évoluer, en direct
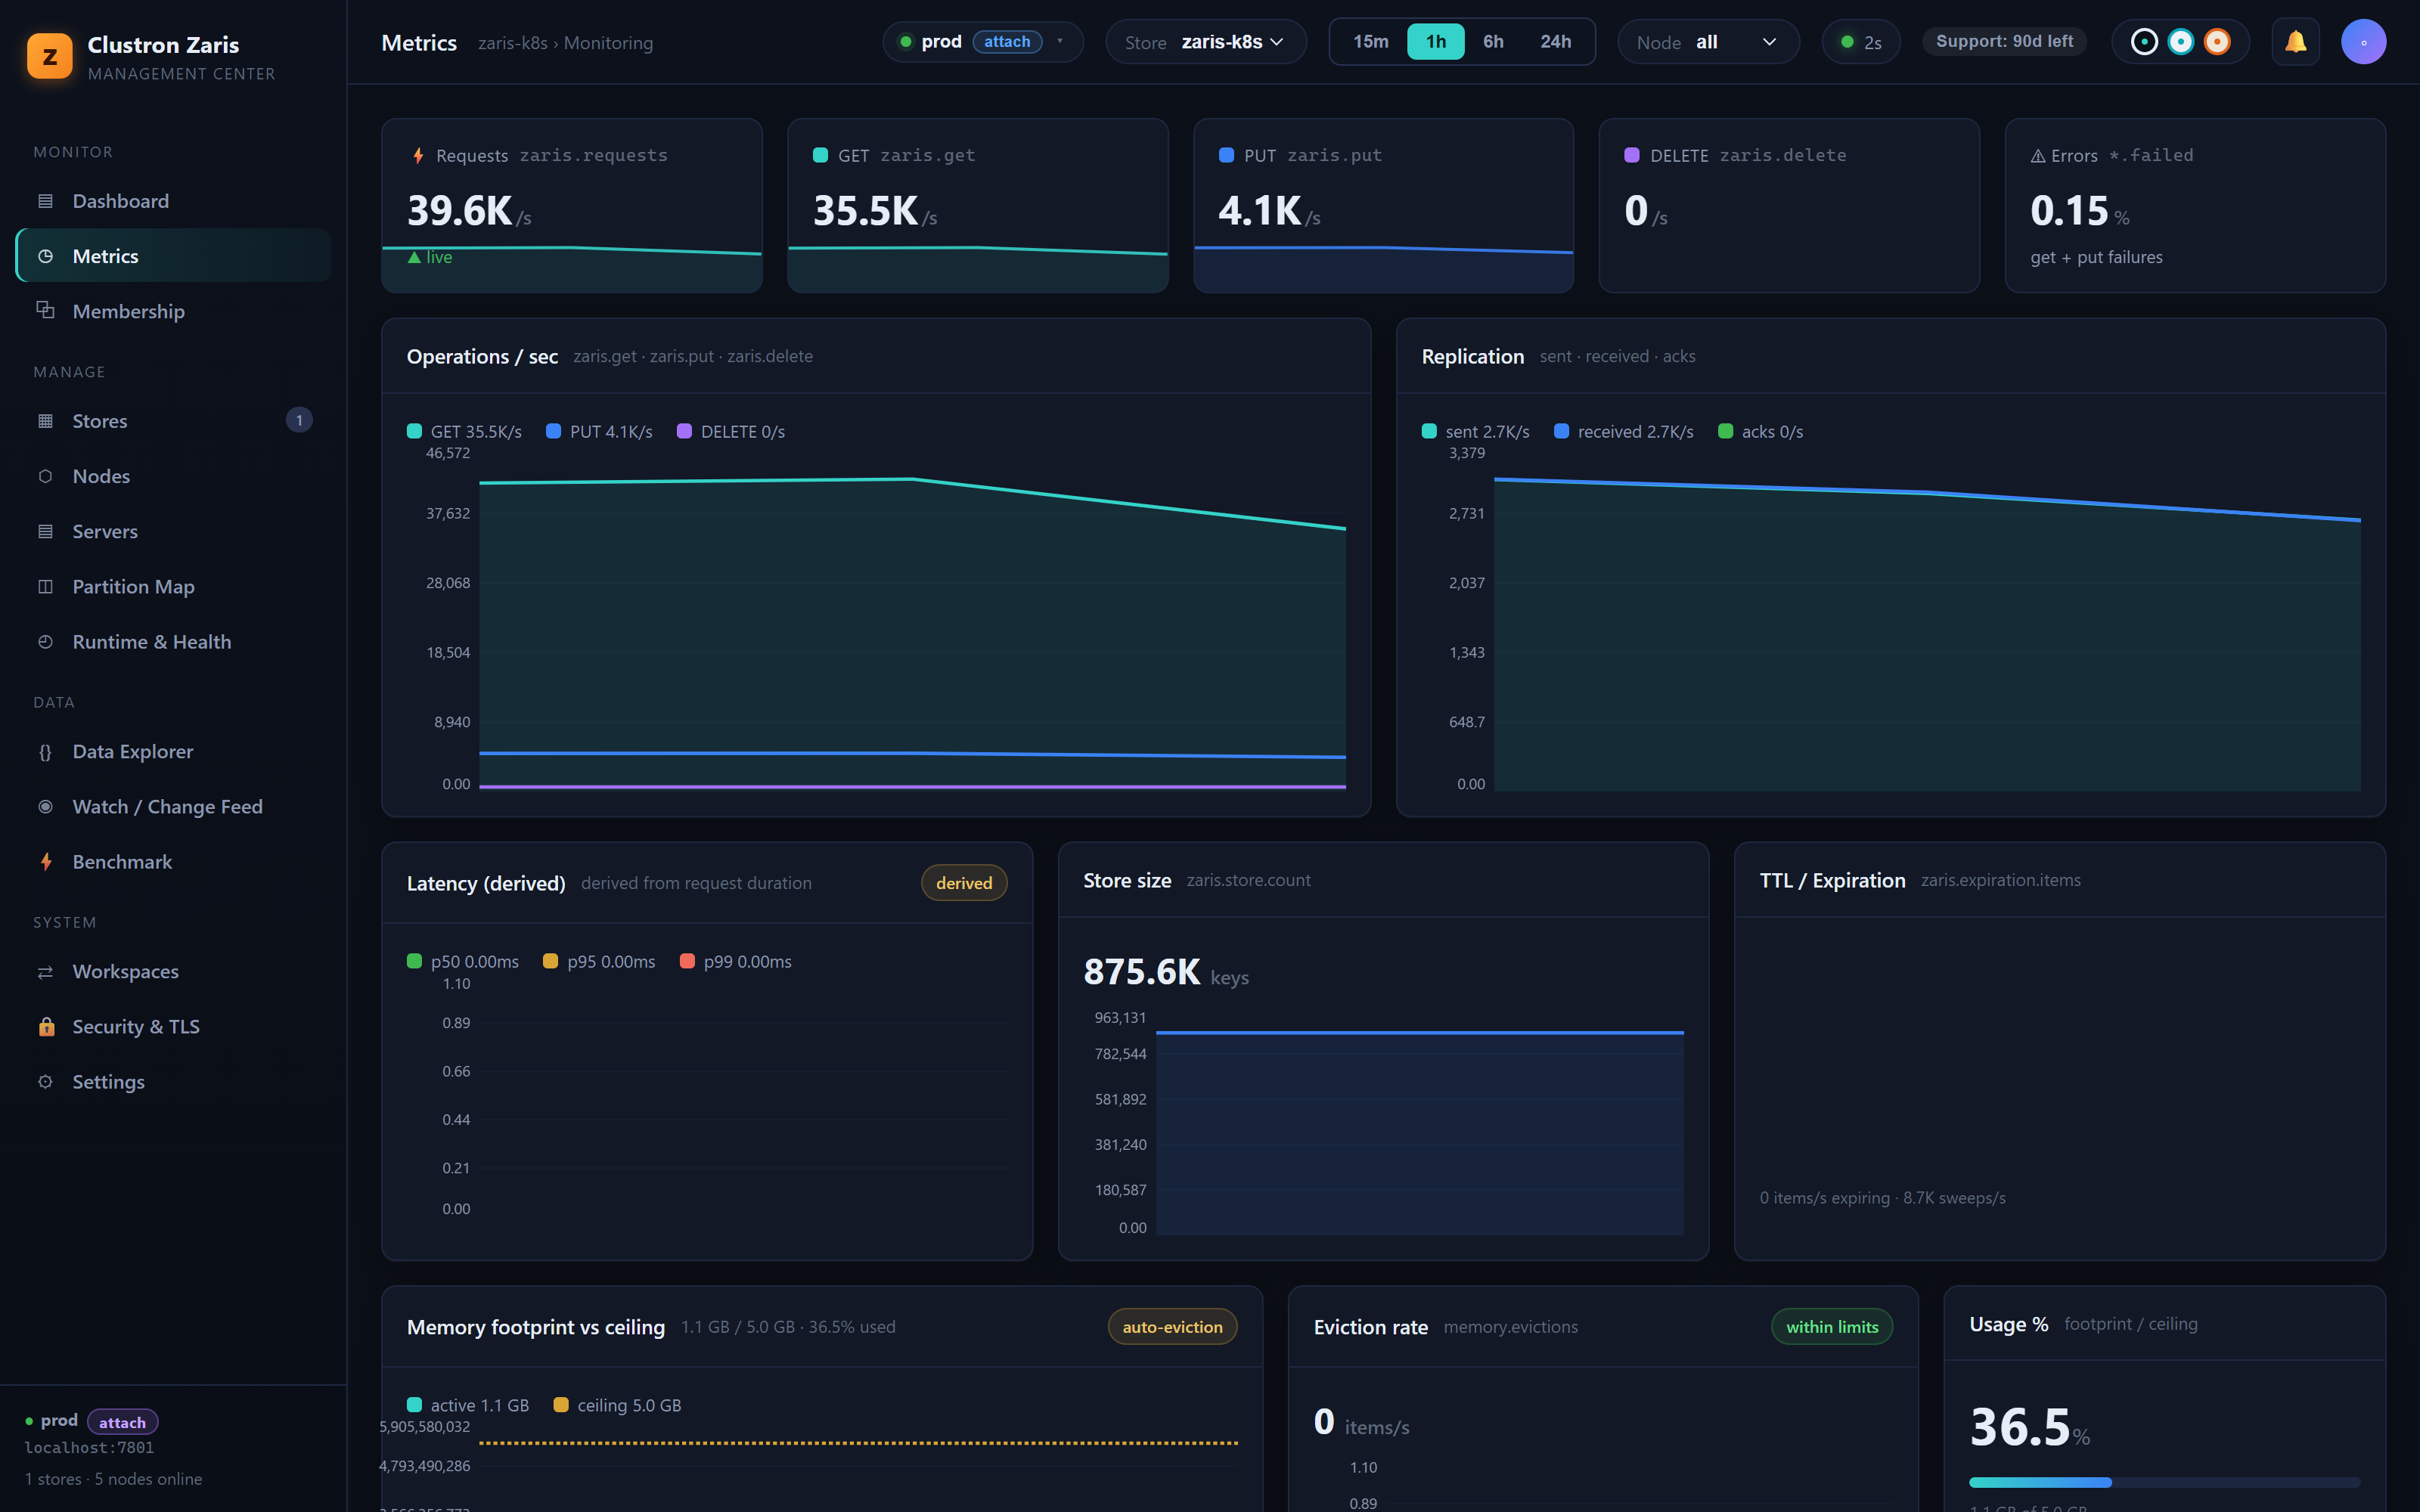
Zaris est conçu pour un très haut débit à une latence inférieure à la milliseconde — et les chiffres montent en charge avec votre matériel, donc ceux qui comptent sont les vôtres. La console diffuse le débit, la réplication et la latence en temps réel, et le benchmark intégré vous permet de le mesurer sur votre propre cluster.
- Ops/sec, réplication et latence dérivée en direct dans la console
- Benchmark intégré pour tester en charge votre véritable cluster
- Exportez tout via OTLP vers la stack que vous exploitez déjà
Arbitrez latence et durabilité, par store
Le même store peut privilégier la vitesse brute ou des garanties plus fortes — les réglages sont de la configuration, pas une réécriture.
Mode de réplication
Async pour la latence d'écriture la plus faible ; Sync avec un quorum (All / Majority) lorsqu'une écriture doit être durable sur les réplicas avant de retourner.
Facteur de réplication
Un RF plus élevé signifie plus de disponibilité mais plus de travail de réplication par écriture. RF2 tolère la perte d'un nœud ; choisissez par store.
Connexions client et basculement
Le client met en pool les connexions et bascule sur la liste d'amorçage, puis route chaque clé directement vers son propriétaire — sans saut par proxy.
TTL et éviction
Une mémoire bornée avec TTL et éviction sous un plafond garde le working set à chaud sans croissance illimitée.
Voyez-le évoluer — dans votre propre cluster
Mettez en place un store, exécutez le benchmark intégré et regardez les chiffres en direct. Puis ajustez-le à votre charge de travail.