Schnell durch den Ort, an dem es läuft
In-Memory, In-Process oder einen Hop entfernt — partitioniert für Parallelität, mit einem allokationsarmen Hot Path und Bulk-Operationen, die das Netzwerk amortisieren. Ein Redis-kompatibler Cache, der auf produktiven Nodes schneller ist, und indizierte Suche, die eine Datenbank über eine Million Datensätze schlägt. Und alles ist live aus der Konsole messbar.
Geschwindigkeit durch Design, nicht durch Benchmark-Tricks
Die Performance ergibt sich daraus, wo die Daten liegen und wie Anfragen sie erreichen — dieselben Eigenschaften gelten, ob Sie eingebettet oder geclustert betreiben.
In-Memory
Daten liegen im RAM, nicht auf der Festplatte. Lese- und Schreibzugriffe warten nie auf Speicher-I/O — Dauerhaftigkeit entsteht durch Replikation, nicht durch fsync.
In-Process-Option
Im eingebetteten Betrieb gibt es überhaupt keinen Netzwerk-Hop — Aufrufe sind Methodenaufrufe. Derselbe Code zieht auf einen Cluster um, wenn Sie einen brauchen.
Partitionierte Parallelität
Keys werden über Partitionen und Nodes verteilt, sodass der Durchsatz mit dem Cluster skaliert — fügen Sie Nodes hinzu, und die Übersicht wächst auf sie.
Allokationsarmer Hot Path
Integrierte Metriken erfassen den Hot Path mit minimalen Allokationen, und der Client poolt Verbindungen — der Overhead bleibt aus Ihrem Latenzbudget heraus.
Bulk- & Batch-Operationen
PutMany / GetMany und gemischte Batches bündeln viele Keys zu einem Round Trip pro Besitzer und verteilen so die Netzwerkkosten.
Asynchrone Replikation
Bei asynchroner Replikation wird ein Schreibvorgang bestätigt, ohne auf jedes Replikat zu warten; wählen Sie Sync + Quorum, wenn Sie stärkere Garantien wünschen.
Sehen Sie es live in Bewegung
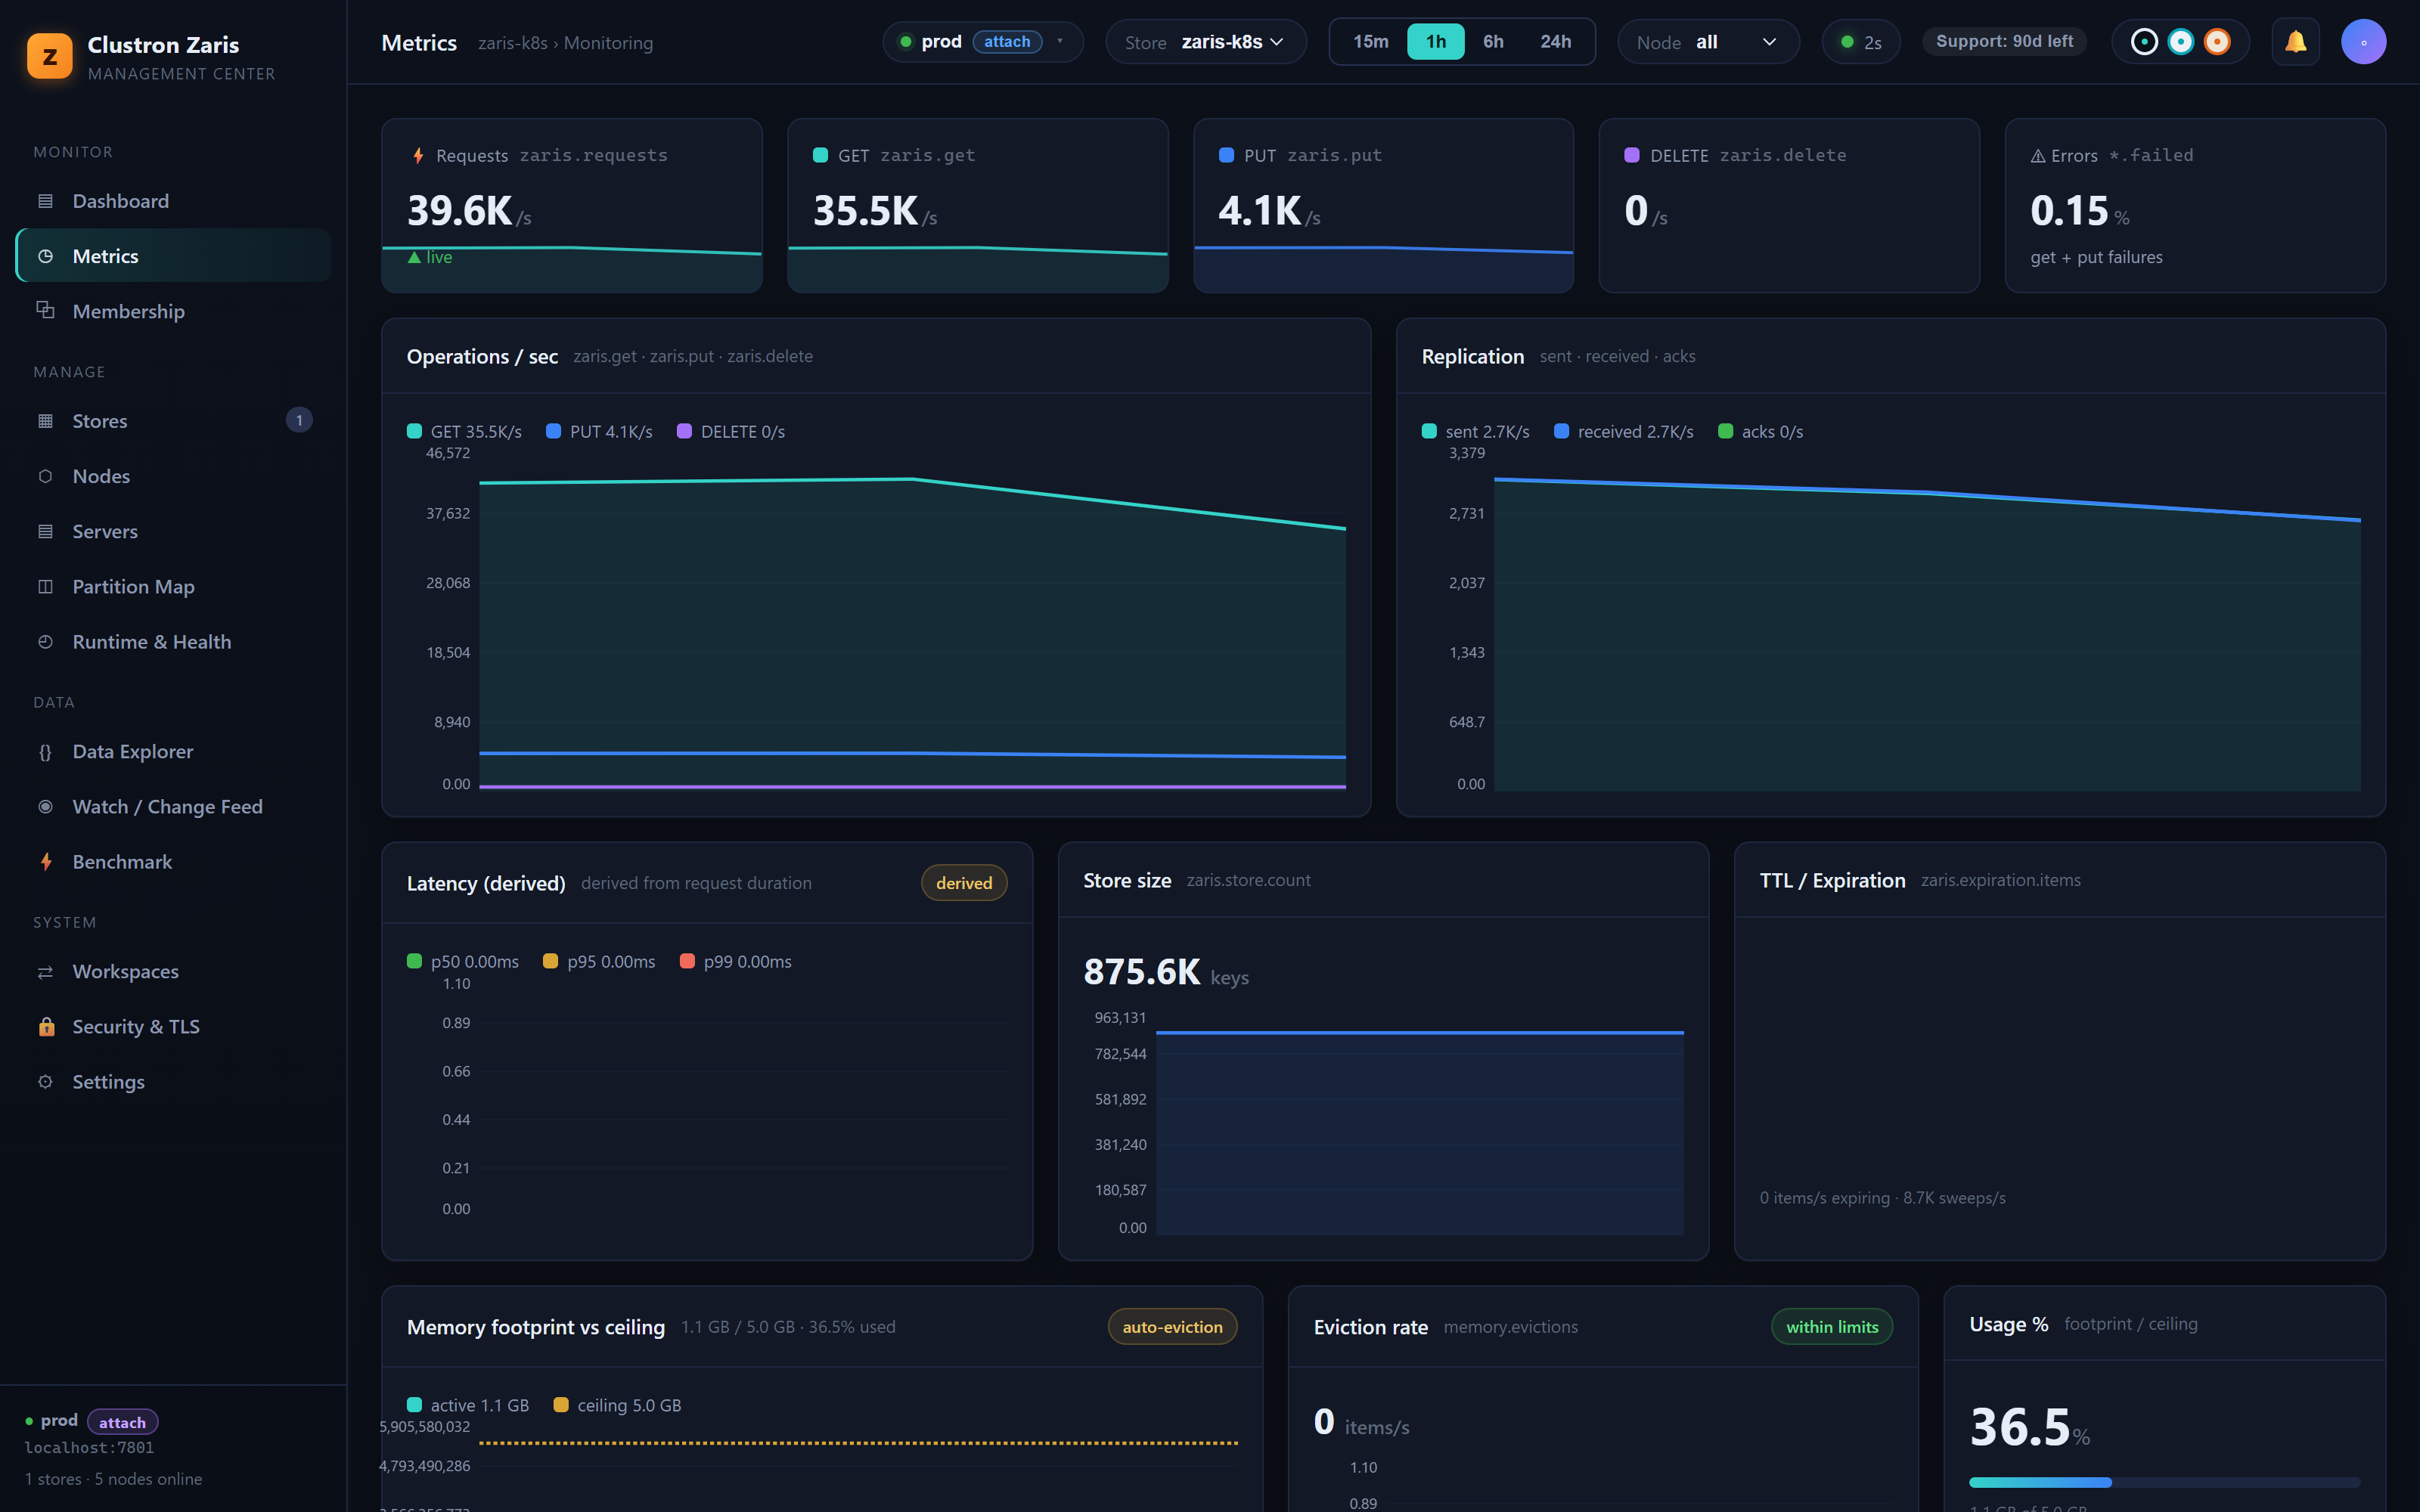
Zaris ist für sehr hohen Durchsatz bei Latenzen unter einer Millisekunde gebaut — und die Zahlen skalieren mit Ihrer Hardware, also zählen Ihre eigenen. Die Konsole streamt Durchsatz, Replikation und Latenz in Echtzeit, und der integrierte Benchmark lässt Sie auf Ihrem eigenen Cluster messen.
- Live-Ops/Sek., Replikation und abgeleitete Latenz in der Konsole
- Integrierter Benchmark, um Ihren echten Cluster zu belasten
- Exportieren Sie alles per OTLP in den Stack, den Sie bereits betreiben
Latenz und Dauerhaftigkeit abwägen, pro Store
Derselbe Store kann rohe Geschwindigkeit oder stärkere Garantien bevorzugen — die Stellschrauben sind Konfiguration, kein Umbau.
Replikationsmodus
Async für die niedrigste Schreiblatenz; Sync mit Quorum (All / Majority), wenn ein Schreibvorgang auf Replikaten dauerhaft sein muss, bevor er zurückkehrt.
Replikationsfaktor
Ein höherer RF bedeutet mehr Verfügbarkeit, aber mehr Replikationsaufwand pro Schreibvorgang. RF2 toleriert den Verlust eines Nodes; wählen Sie pro Store.
Client-Verbindungen & Failover
Der Client poolt Verbindungen und wechselt per Failover über die Seed-Liste, dann leitet er jeden Key direkt an seinen Besitzer — ohne Proxy-Hop.
TTL & Eviction
Begrenzter Speicher mit TTL und Eviction unter einer Obergrenze hält das Working Set heiß, ohne unbegrenzt zu wachsen.
Sehen Sie es in Bewegung — im eigenen Cluster
Setzen Sie einen Store auf, führen Sie den integrierten Benchmark aus und beobachten Sie die Zahlen live. Stimmen Sie ihn dann auf Ihre Workload ab.