Saltar al contenido principal

25 publicaciones etiquetados con "Sistemas Distribuidos"

Artículos sobre la arquitectura y el diseño de sistemas distribuidos.

Ver Todas las Etiquetas

Estructuras de datos que se replican: hashes, listas, conjuntos y conjuntos ordenados en Zaris

· 7 min de lectura
Clustron Team
Ingeniería de Sistemas Distribuidos

Hashes, listas, conjuntos y conjuntos ordenados nativos, replicados como cualquier otra clave en Zaris

Zaris 1.x almacenaba valores. Zaris 2.0.0 almacena colecciones. Los hashes, listas, conjuntos y conjuntos ordenados son ahora tipos de primera clase, del lado del servidor, con APIs de .NET reales y tipadas y, lo que es igual de importante, se comportan como todo lo demás en el almacén.

Esa última parte es lo que la gente suele entender mal. En muchos sistemas, las "estructuras de datos" son una ilusión del lado del cliente: una biblioteca serializa un diccionario en un blob, lo hace Put y lo llama un hash. Funciona hasta que dos clientes tocan la misma colección a la vez, o hasta que te preguntas qué pasa en una conmutación por error. En Zaris, un hash es un hash en el servidor. Reside en la partición propietaria de su clave, se replica a la réplica de esa partición y sobrevive a la pérdida de un nodo exactamente igual que una clave simple.

Zaris 2.0.0: estructuras de datos nativas, Streams y un front-end del protocolo de Redis

· 7 min de lectura
Clustron Team
Ingeniería de Sistemas Distribuidos

Zaris 2.0.0 — Estructuras de datos nativas, Streams y un front-end del protocolo de Redis

Hoy lanzamos Zaris 2.0.0, la mayor versión desde que Zaris alcanzó la disponibilidad general, y la primera con un salto de versión mayor. Convierte a Zaris de un almacén clave/valor rápido y replicado en un servidor completo de estructuras de datos: hashes, listas, conjuntos, conjuntos ordenados, pub/sub y Redis Streams nativos, todos particionados y replicados de la misma forma que ya lo están tus claves.

Y abre la puerta a todos los demás. Cada nodo ahora puede exponer un front-end del protocolo de Redis (RESP), de modo que una aplicación en Python, Ruby, Java, Go —cualquier lenguaje con un cliente de Redis— puede apuntar a Zaris y usarlo como reemplazo directo, sin un SDK nativo y sin reescribir una línea.

El número de versión es un 2, no un 1.x, por una razón: la 2.0.0 cambia el protocolo de cable. Lee la nota de actualización de más abajo antes de implementarlo.

Zaris 0.9.0 ya está aquí — y con disponibilidad general

· 5 min de lectura
Clustron Team
Ingeniería de Sistemas Distribuidos

Zaris 0.9.0 — Disponibilidad General

Hoy lanzamos Zaris 0.9.0 y, con él, Zaris alcanza la disponibilidad general. Está listo para producción, es multiplataforma y ahora cuenta con soporte comercial.

Si aún no te has topado con él: Zaris es un almacén clave/valor distribuido y en memoria para .NET. Es rápido, replicado, y puedes operarlo desde un navegador, PowerShell o directamente desde tu aplicación. Esta versión es la culminación de ese trabajo: el punto en el que un "proyecto prometedor" se convierte en "algo que puedes poner en producción".

Bloqueos Distribuidos Explicados

· 5 min de lectura
Clustron Team
Ingeniería de Sistemas Distribuidos

Una guía práctica para desarrolladores de .NET

Introducción​

A medida que las aplicaciones escalan a través de varias máquinas, la coordinación se convierte en uno de los aspectos más desafiantes del diseño de sistemas.

En una aplicación de una sola máquina, la exclusión mutua es sencilla. Los desarrolladores pueden apoyarse en primitivas del lenguaje como lock en C#, Mutex o Semaphore para garantizar que solo un hilo acceda a un recurso compartido a la vez.

Sin embargo, estas primitivas solo funcionan dentro de un único proceso o máquina.

Una vez que las aplicaciones se ejecutan en varios servicios o nodos, los mecanismos de bloqueo tradicionales dejan de funcionar. Dos servicios que se ejecutan en diferentes máquinas no pueden apoyarse en una instrucción lock local para coordinar el acceso a un estado compartido.

Aquí es donde los bloqueos distribuidos se vuelven esenciales.

Los bloqueos distribuidos permiten que los servicios de un clúster coordinen el acceso a recursos compartidos garantizando al mismo tiempo que solo un participante mantenga el bloqueo en un momento dado.


Bloqueos locales frente a bloqueos distribuidos​

Un bloqueo local típico en C# tiene este aspecto:

private static readonly object _lock = new object();

public void ProcessOrder()
{
lock(_lock)
{
Console.WriteLine("Processing order safely.");
}
}

Esto funciona perfectamente dentro de un único proceso.

Sin embargo, si tu aplicación se ejecuta en varias instancias de servicio, cada instancia tiene su propio objeto _lock. El bloqueo ya no coordina el trabajo en todo el sistema.

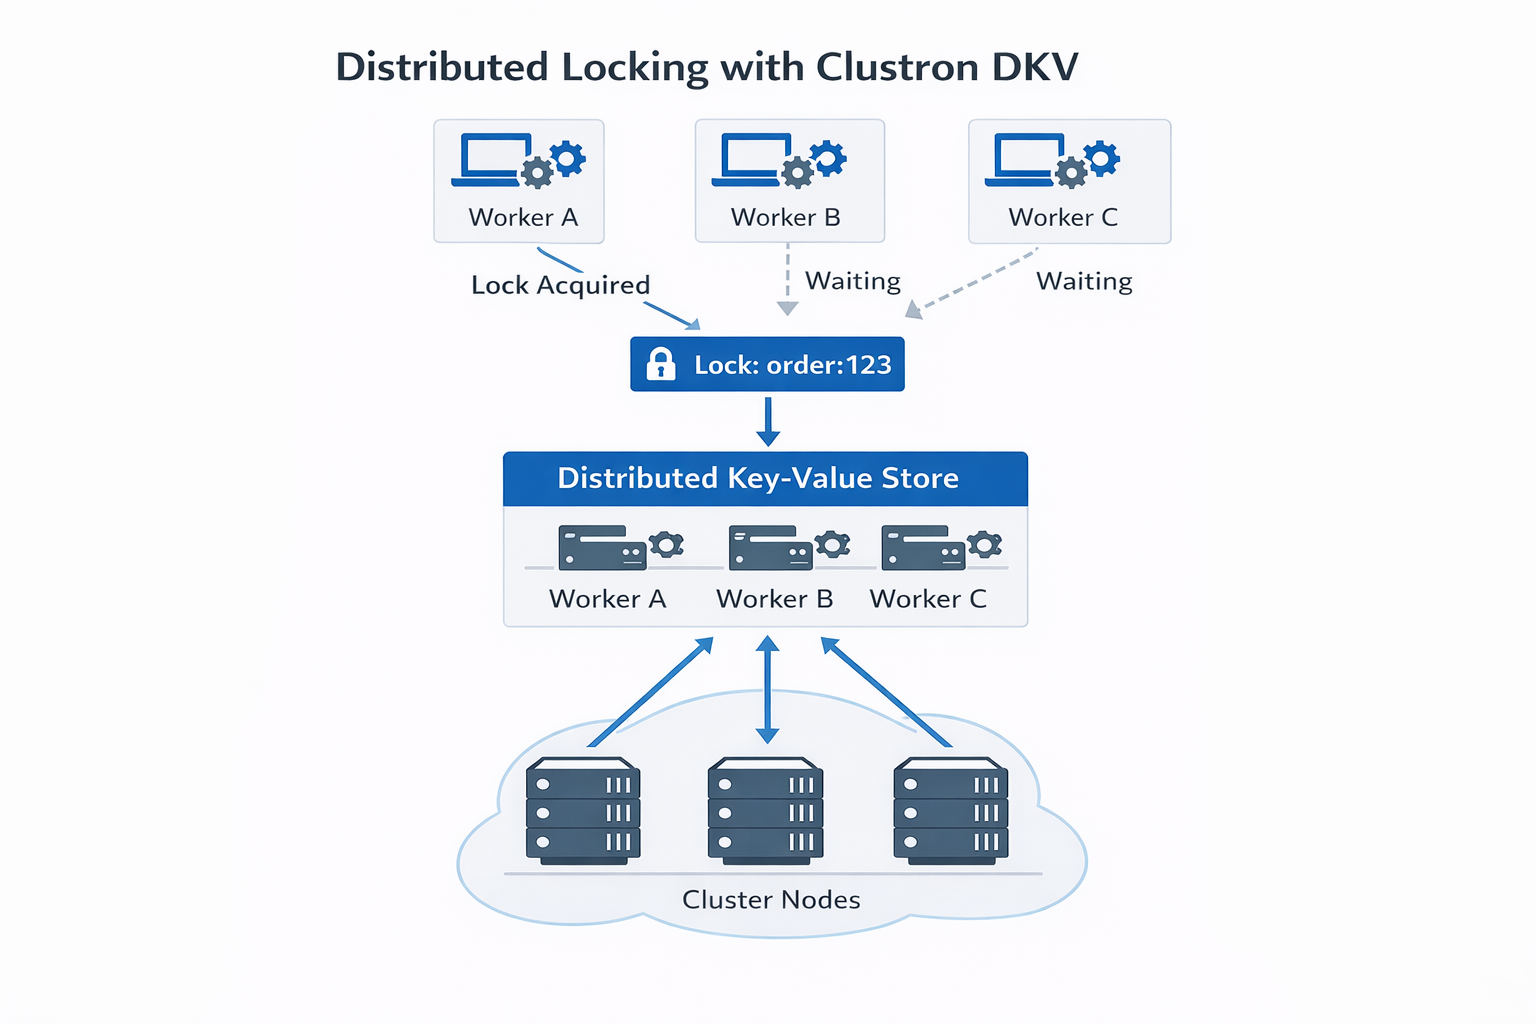
Worker A → lock acquired Worker B → lock acquired Worker C → lock acquired

Todos los trabajadores proceden simultáneamente, lo que anula el propósito del bloqueo.

Los sistemas distribuidos requieren un mecanismo de coordinación compartido.


Bloqueo Distribuido


La idea detrás de los bloqueos distribuidos​

Un bloqueo distribuido utiliza un sistema compartido para representar la propiedad del bloqueo.

En lugar de bloquear la memoria, un nodo registra la propiedad del bloqueo en un sistema de coordinación distribuida como:

  • un almacén clave‑valor distribuido
  • un servicio de coordinación
  • una caché distribuida

Concepto de ejemplo:

Lock Key: order:123 Owner: worker‑1

Si otro trabajador intenta adquirir el mismo bloqueo, la operación falla hasta que el bloqueo se libera o expira.


Escenario del mundo real: procesamiento distribuido de facturas​

Imagina un clúster de trabajadores que procesan facturas.

Worker A Worker B Worker C

Todos los trabajadores buscan facturas pendientes.

Sin bloqueo:

Worker A → processes invoice #101 Worker B → processes invoice #101 Worker C → processes invoice #101

La misma factura podría procesarse varias veces.

Un bloqueo distribuido garantiza que solo un trabajador procese la factura.


Bloqueos distribuidos con Clustron DKV​

Clustron DKV proporciona primitivas integradas para la coordinación distribuida.

Los bloqueos se gestionan a través de la API de bloqueos (Locks API), y las operaciones sobre claves bloqueadas deben incluir el identificador de bloqueo (lock handle) correcto.


Adquirir un bloqueo​

Un cliente adquiere primero un bloqueo para una clave específica.

var locks = ((IDkv)client).Locks;

var key = "order:123";

var lockHandle = await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

if (lockHandle == null)
{
Console.WriteLine("Failed to acquire lock.");
return;
}

Console.WriteLine("Lock acquired.");

El identificador de bloqueo devuelto representa la propiedad del bloqueo.


Realizar operaciones bajo el bloqueo​

Una vez adquirido un bloqueo, las operaciones deben incluir el identificador de bloqueo.

var result = await client.PutAsync(
key,
"processed",
Put.WithLock(lockHandle.Handle));

if (result.IsSuccess)
{
Console.WriteLine("Value updated safely.");
}

Solo el propietario del bloqueo puede modificar el valor.


Lectura con el bloqueo​

Las lecturas también pueden respetar la propiedad del bloqueo.

var value = await client.GetAsync<string>(
key,
Get.WithLock(lockHandle.Handle));

if (value.IsSuccess)
{
Console.WriteLine($"Value: {value.Value}");
}

Operaciones en competencia sin el bloqueo​

Si otro trabajador intenta modificar la clave sin el bloqueo, la operación falla.

var attempt = await client.PutAsync(key, "new-value");

if (!attempt.IsSuccess)
{
Console.WriteLine($"Operation rejected: {attempt.Status}");
}

Resultado:

KvStatus.Locked

Esto evita la modificación concurrente del mismo recurso.


Liberar el bloqueo​

Una vez finalizado el trabajo, el bloqueo puede liberarse.

await lockHandle.ReleaseAsync();

Console.WriteLine("Lock released.");

Después de liberar el bloqueo, otro trabajador puede adquirirlo.


Flujo de trabajo de ejemplo en el clúster​

Worker A → Acquire Lock → Success Worker B → Acquire Lock → Failed Worker C → Acquire Lock → Failed

Worker A → Update Key Worker A → Release Lock

Solo un trabajador realiza la operación, lo que garantiza la corrección.


Gestión de fallos​

Los bloqueos en Clustron tienen un límite de tiempo.

Al adquirir un bloqueo, debe especificarse una duración:

await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

Si el cliente que mantiene el bloqueo se bloquea o se desconecta, el bloqueo expira finalmente, lo que permite que otro trabajador lo adquiera.

Esto evita que los bloqueos permanezcan retenidos de forma permanente.


Buenas prácticas​

Al implementar bloqueos distribuidos:

  • Mantén las secciones críticas cortas
  • Evita los bloqueos globales cuando sea posible
  • Particiona los bloqueos por recurso
  • Diseña siempre pensando en los escenarios de fallo

Reflexiones finales​

Los bloqueos distribuidos son una de las primitivas de coordinación más fundamentales en los sistemas distribuidos.

Permiten que los servicios que se ejecutan en varias máquinas coordinen de forma segura el acceso a recursos compartidos preservando al mismo tiempo la corrección del sistema.

Plataformas como Clustron DKV lo simplifican proporcionando primitivas de bloqueo integradas, operaciones atómicas y sólidas garantías de consistencia.

En el próximo artículo, exploraremos otra primitiva esencial de los sistemas distribuidos:

La Elección de Líder.

Construcción de Sistemas Distribuidos

· 5 min de lectura
Clustron Team
Ingeniería de Sistemas Distribuidos

Una guía práctica para desarrolladores de .NET

Introducción​

La mayoría de los sistemas backend comienzan su vida en una sola máquina.

Una aplicación de ASP.NET Core procesa solicitudes, una base de datos almacena los datos de la aplicación y los trabajadores en segundo plano gestionan tareas asíncronas como el envío de correos electrónicos o la generación de informes. En este entorno, la concurrencia es manejable y la coordinación entre componentes es relativamente sencilla.

Sin embargo, a medida que el sistema crece, las cosas empiezan a cambiar.

El tráfico aumenta, se despliegan más instancias de la aplicación detrás de un balanceador de carga y los servicios comienzan a ejecutarse en varias máquinas. Lo que antes era una sola aplicación evoluciona hacia un sistema distribuido.

En este punto, la naturaleza del problema cambia drásticamente.

Los desafíos ya no se limitan a escribir una lógica de negocio correcta. Ahora los desarrolladores deben lidiar con la coordinación entre máquinas, los fallos de red, las interrupciones parciales y el mantenimiento de la consistencia en el estado distribuido.

Aquí es donde comienza la ingeniería de sistemas distribuidos.
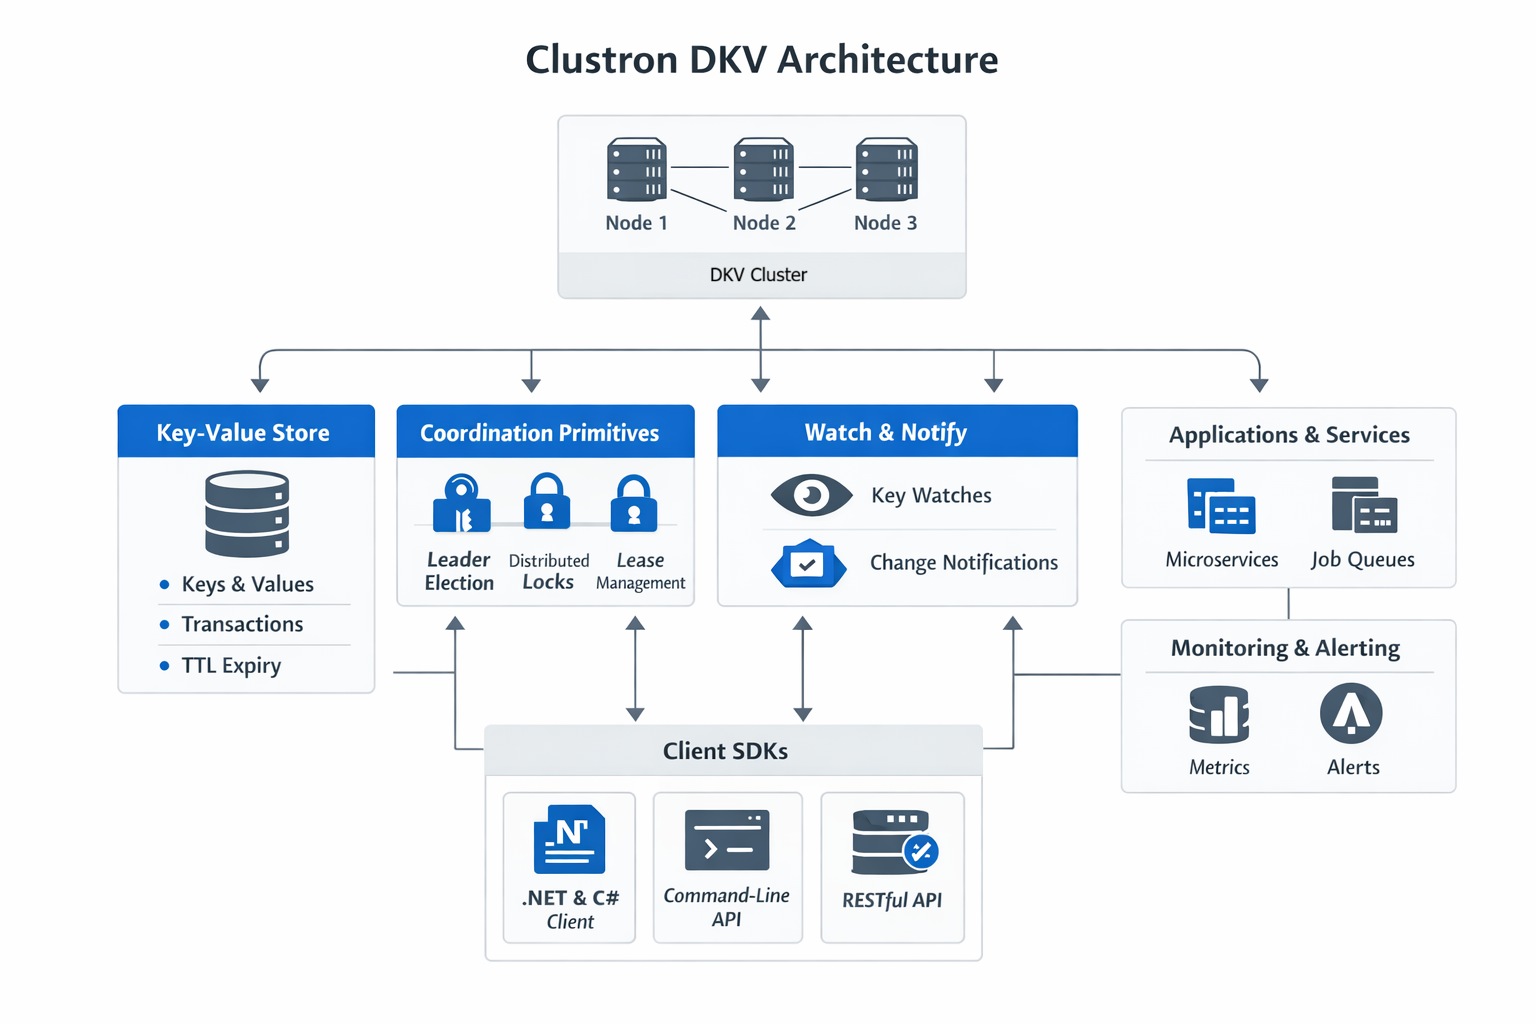

Arquitectura de Sistemas Distribuidos


¿Qué es un sistema distribuido?​

Un sistema distribuido es un conjunto de computadoras independientes que aparecen ante el usuario como un único sistema coherente.

En lugar de ejecutar toda la lógica en una sola máquina, las responsabilidades se distribuyen entre varios nodos que se comunican a través de la red.

Algunos ejemplos son:

  • Arquitecturas de microservicios
  • Bases de datos distribuidas
  • Cachés en clúster
  • Colas de mensajes
  • Plataformas de infraestructura en la nube

Estos sistemas proporcionan escalabilidad y resiliencia, pero introducen nuevas complejidades.


Por qué los sistemas distribuidos son difíciles​

A diferencia de una aplicación de una sola máquina, los sistemas distribuidos deben lidiar con realidades como:

Fallos de red​

En los sistemas distribuidos, la comunicación se produce a través de una red. Las redes pueden ser lentas, poco fiables o estar temporalmente no disponibles.

Una solicitud puede fallar porque el nodo remoto se bloqueó, porque la red descartó paquetes o porque se produjo un tiempo de espera agotado.

El sistema debe gestionar estos escenarios con elegancia.


Fallos parciales​

En un sistema distribuido, los componentes pueden fallar de forma independiente.

Un nodo de un clúster puede bloquearse mientras otros permanecen en buen estado. Una instancia de servicio puede reiniciarse mientras otros servicios siguen ejecutándose.

Esto significa que el sistema debe funcionar correctamente incluso cuando solo una parte de él está operativa.


Desafíos de consistencia​

Cuando los datos se replican en varios nodos, mantenerlos consistentes se vuelve difícil.

Por ejemplo:

  • Dos nodos pueden intentar actualizar los mismos datos simultáneamente.
  • Los retrasos de red pueden provocar que los nodos difieran temporalmente sobre el estado actual.
  • Un nodo puede bloquearse después de realizar solo una parte de una operación.

Diseñar sistemas que mantengan un estado consistente a pesar de estos escenarios requiere una coordinación cuidadosa.


Bloques de construcción clave de los sistemas distribuidos​

La mayoría de los sistemas distribuidos se basan en unas pocas primitivas fundamentales.

Comprender estas primitivas ayuda a los desarrolladores a diseñar arquitecturas fiables.


Almacenamiento distribuido​

A menudo, los datos deben almacenarse en varias máquinas.

Esto permite:

  • escalado horizontal
  • tolerancia a fallos
  • alta disponibilidad

Los almacenes clave-valor distribuidos se utilizan comúnmente para este propósito.


Coordinación​

Los nodos deben coordinar acciones como:

  • elección de líder
  • bloqueo distribuido
  • pertenencia al clúster
  • actualizaciones de configuración

Sin mecanismos de coordinación, varios nodos podrían intentar operaciones conflictivas.


Consenso​

Algunos sistemas requieren garantías sólidas sobre el estado compartido.

Los algoritmos de consenso como Raft o Paxos permiten que los nodos lleguen a acuerdos sobre decisiones incluso en presencia de fallos.

Estos algoritmos son fundamentales para las bases de datos distribuidas y los servicios de coordinación.


Particionamiento y replicación​

Los datos normalmente se:

  • particionan entre nodos para distribuir la carga
  • replican para proteger contra fallos

Equilibrar el rendimiento, la disponibilidad y la consistencia es uno de los principales desafíos de diseño.


Patrones comunes de los sistemas distribuidos​

Varios patrones aparecen repetidamente en los sistemas del mundo real.

Algunos ejemplos son:

  • Elección de líder para coordinar las actividades del clúster
  • Bloqueos distribuidos para garantizar la exclusión mutua
  • Colas de trabajos para el procesamiento asíncrono
  • Limitadores de tasa para controlar el volumen de solicitudes
  • Protocolos de transacción para actualizaciones atómicas entre varios nodos

Estos patrones forman la base de muchas plataformas a gran escala.


El papel de los sistemas de coordinación​

Para simplificar el desarrollo distribuido, muchas organizaciones se apoyan en sistemas de coordinación como:

  • etcd
  • ZooKeeper
  • Consul

Estos sistemas proporcionan primitivas como:

  • elección de líder
  • bloqueos distribuidos
  • pertenencia al clúster
  • almacenamiento de configuración

Las aplicaciones pueden entonces construir comportamientos de nivel superior sobre estas primitivas.


Los sistemas distribuidos en el ecosistema .NET​

Aunque las herramientas de infraestructura distribuida se asocian a menudo con otros ecosistemas, las aplicaciones de .NET operan cada vez más en entornos distribuidos.

Los sistemas modernos de .NET utilizan con frecuencia:

  • Kubernetes
  • cachés distribuidas
  • microservicios
  • arquitecturas orientadas a eventos

Como resultado, la coordinación y la gestión del estado distribuido son cada vez más importantes también para los desarrolladores de .NET.


Reflexiones finales​

Construir sistemas distribuidos es fundamentalmente diferente de construir aplicaciones tradicionales de una sola máquina.

Los desafíos de la comunicación en red, los fallos parciales y la consistencia de los datos introducen complejidades que requieren patrones e infraestructura especializados.

Afortunadamente, al comprender los bloques de construcción clave —almacenamiento, coordinación, consenso y replicación— los desarrolladores pueden diseñar sistemas que escalan de forma fiable y permanecen resilientes ante los fallos.

En futuros artículos, exploraremos algunas de estas primitivas con más detalle, incluida la elección de líder, los patrones de coordinación distribuida y las implementaciones prácticas en .NET.