Un guide pratique pour les développeurs .NET
Introduction
La plupart des systèmes backend commencent leur existence sur une seule machine.
Une application ASP.NET Core traite les requêtes, une base de données stocke les données applicatives et des workers d'arrière-plan gèrent les tâches asynchrones telles que l'envoi d'e-mails ou la génération de rapports. Dans cet environnement, la concurrence reste gérable et la coordination entre les composants est relativement simple.
À mesure que le système grandit, cependant, les choses commencent à changer.
Le trafic augmente, davantage d'instances applicatives sont déployées derrière un load balancer et les services s'exécutent sur plusieurs machines. Ce qui était autrefois une application unique évolue vers un système distribué.
À ce stade, la nature du problème change radicalement.
Les défis ne se limitent plus à l'écriture d'une logique métier correcte. Les développeurs doivent désormais composer avec la coordination entre machines, les pannes réseau, les défaillances partielles et le maintien de la cohérence sur un état distribué.
C'est ici que commence l'ingénierie des systèmes distribués.
Qu'est-ce qu'un système distribué ?
Un système distribué est un ensemble d'ordinateurs indépendants qui apparaissent à l'utilisateur comme un système cohérent unique.
Au lieu d'exécuter toute la logique sur une seule machine, les responsabilités sont réparties sur plusieurs nœuds qui communiquent par le réseau.
En voici quelques exemples :
- Les architectures microservices
- Les bases de données distribuées
- Les caches en cluster
- Les files de messages
- Les plateformes d'infrastructure cloud
Ces systèmes offrent évolutivité et résilience, mais introduisent de nouvelles complexités.
Pourquoi les systèmes distribués sont difficiles
Contrairement à une application mono-machine, les systèmes distribués doivent composer avec des réalités telles que :
Les pannes réseau
Dans les systèmes distribués, la communication passe par un réseau. Les réseaux peuvent être lents, peu fiables ou temporairement indisponibles.
Une requête peut échouer parce que le nœud distant s'est arrêté brutalement, parce que le réseau a perdu des paquets ou parce qu'un timeout s'est produit.
Le système doit gérer ces scénarios avec élégance.
Les défaillances partielles
Dans un système distribué, les composants peuvent tomber en panne indépendamment les uns des autres.
Un nœud d'un cluster peut s'arrêter brutalement tandis que les autres restent sains. Une instance de service peut redémarrer pendant que d'autres services continuent de fonctionner.
Cela signifie que le système doit fonctionner correctement même lorsqu'une partie seulement de celui-ci est opérationnelle.
Les défis de cohérence
Lorsque des données sont répliquées sur plusieurs nœuds, les maintenir cohérentes devient difficile.
Par exemple :
- Deux nœuds peuvent tenter de mettre à jour la même donnée simultanément.
- Les délais réseau peuvent amener des nœuds à être temporairement en désaccord sur l'état courant.
- Un nœud peut s'arrêter brutalement après n'avoir exécuté qu'une partie d'une opération.
Concevoir des systèmes qui maintiennent un état cohérent malgré ces scénarios exige une coordination minutieuse.
Briques fondamentales des systèmes distribués
La plupart des systèmes distribués reposent sur quelques primitives essentielles.
Comprendre ces primitives aide les développeurs à concevoir des architectures fiables.
Le stockage distribué
Les données doivent souvent être stockées sur plusieurs machines.
Cela permet :
- la mise à l'échelle horizontale
- la tolérance aux pannes
- la haute disponibilité
Les stores clé-valeur distribués sont couramment utilisés à cette fin.
La coordination
Les nœuds doivent coordonner des actions telles que :
- l'élection de leader
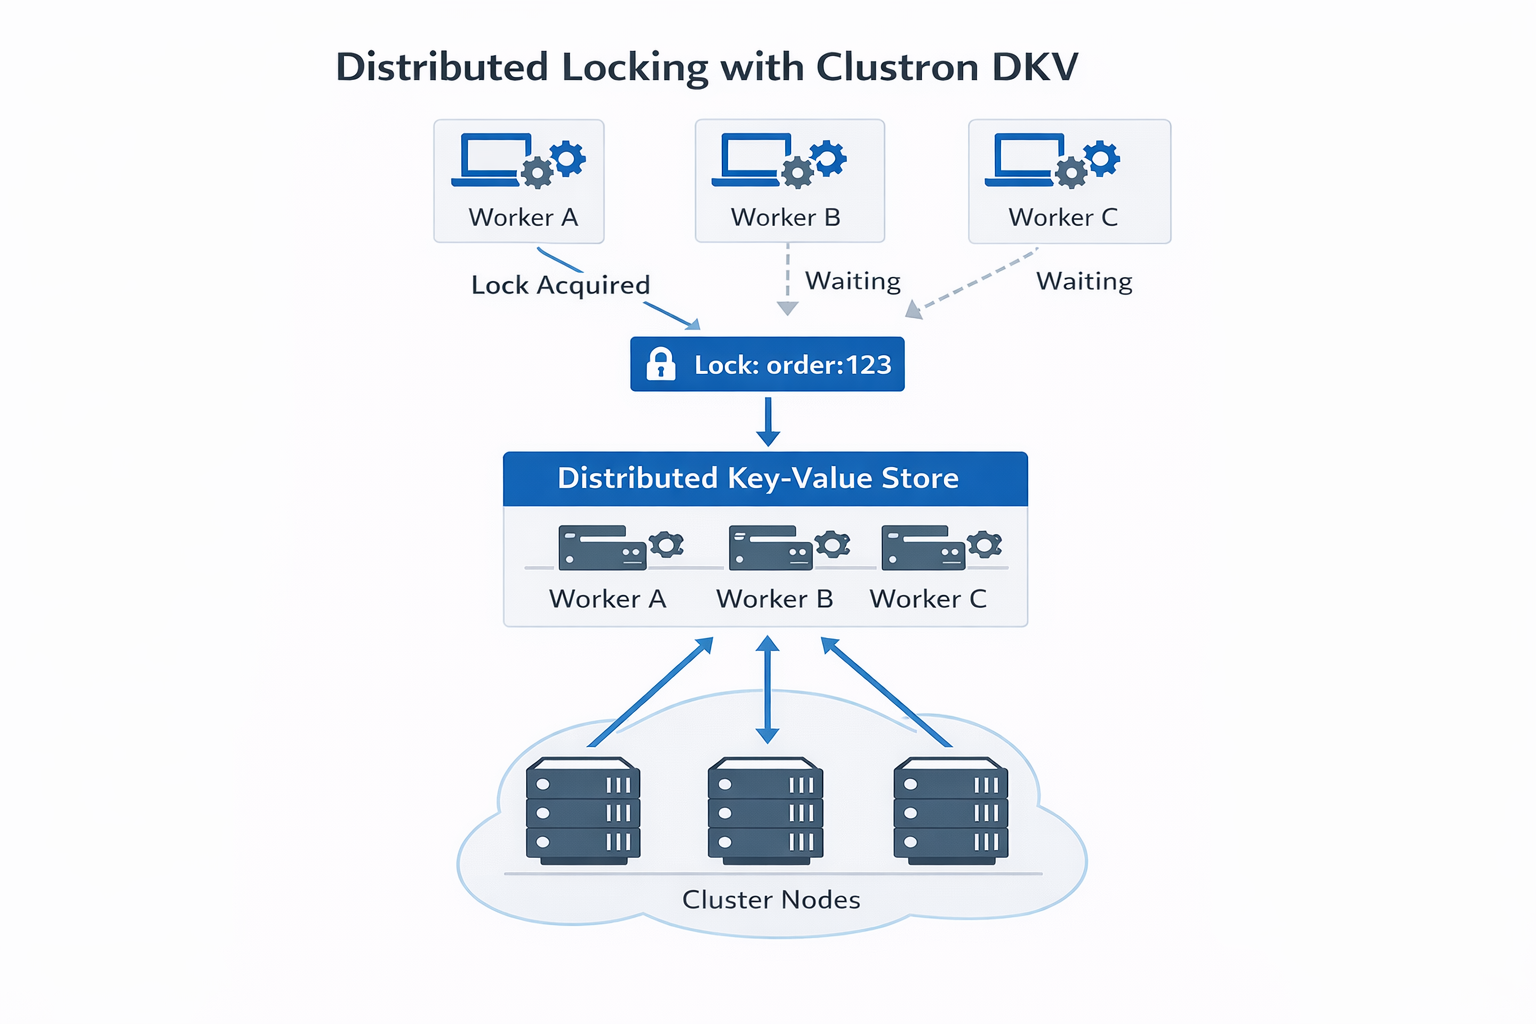
- le verrouillage distribué
- l'appartenance au cluster
- les mises à jour de configuration
Sans mécanismes de coordination, plusieurs nœuds pourraient tenter des opérations conflictuelles.
Le consensus
Certains systèmes exigent de fortes garanties sur l'état partagé.
Les algorithmes de consensus tels que Raft ou Paxos permettent aux nœuds de s'accorder sur des décisions même en présence de défaillances.
Ces algorithmes sont fondamentaux pour les bases de données distribuées et les services de coordination.
Le partitionnement et la réplication
Les données sont généralement :
- partitionnées entre les nœuds pour répartir la charge
- répliquées pour se protéger contre les défaillances
Équilibrer performance, disponibilité et cohérence est l'un des défis de conception fondamentaux.
Modèles courants des systèmes distribués
Plusieurs modèles reviennent régulièrement dans les systèmes réels.
En voici quelques exemples :
- L'élection de leader pour coordonner les activités du cluster
- Les verrous distribués pour garantir l'exclusion mutuelle
- Les files de tâches pour le traitement asynchrone
- Les limiteurs de débit pour contrôler le volume de requêtes
- Les protocoles de transaction pour les mises à jour atomiques multi-nœuds
Ces modèles constituent le socle de nombreuses plateformes à grande échelle.
Le rôle des systèmes de coordination
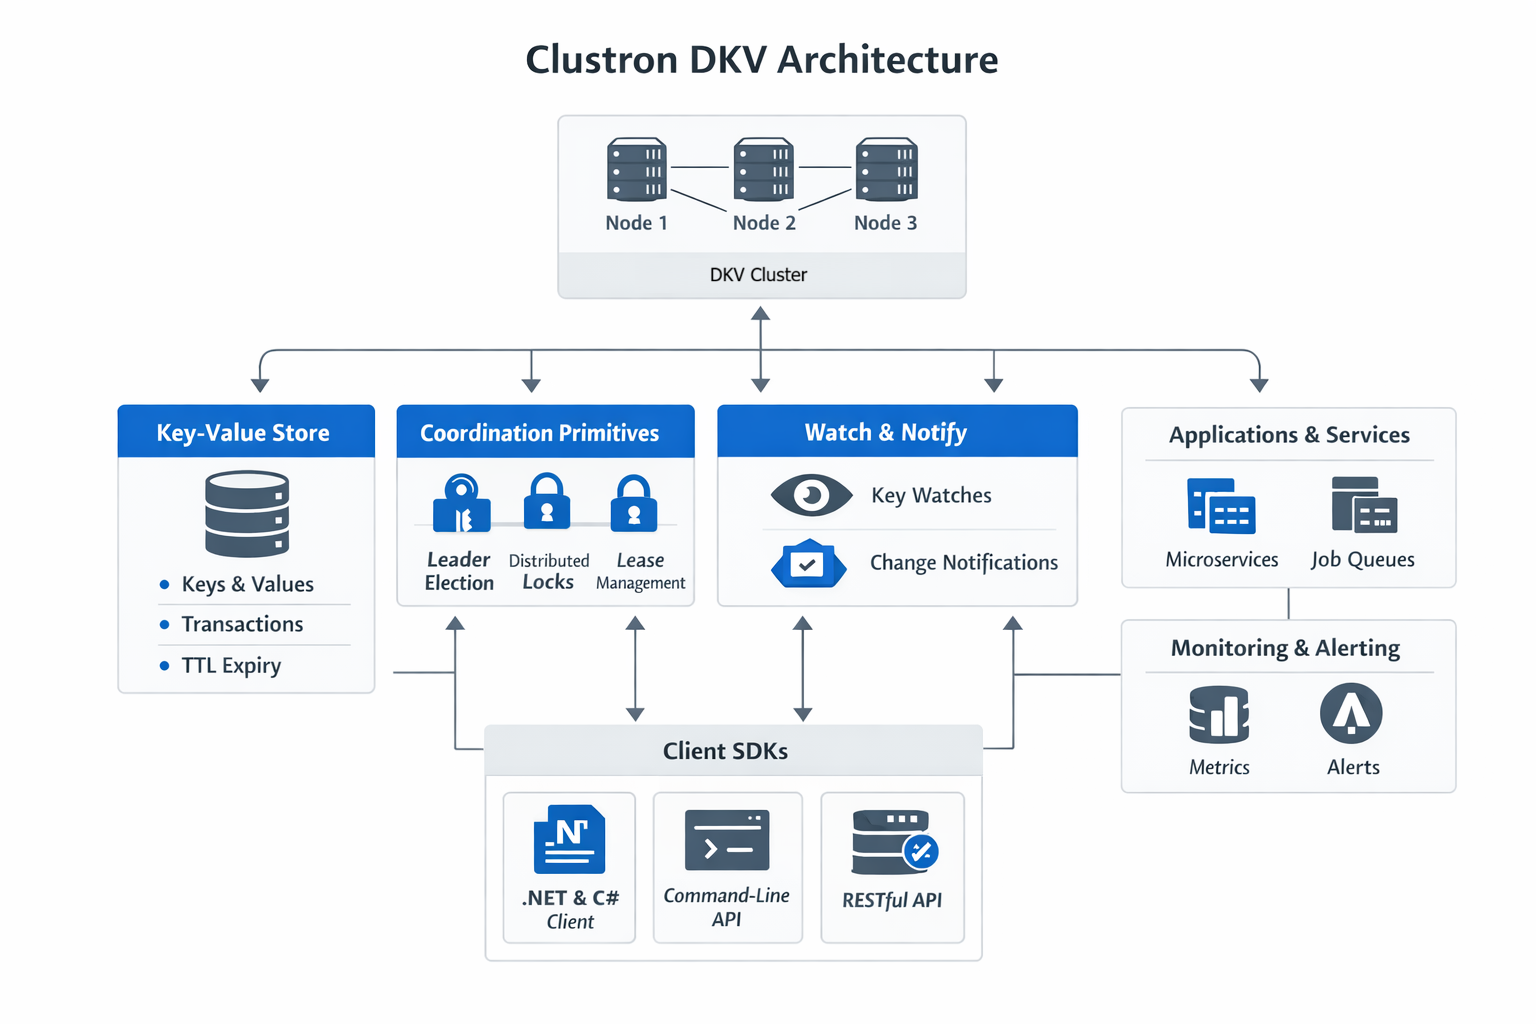
Pour simplifier le développement distribué, de nombreuses organisations s'appuient sur des systèmes de coordination tels que :
Ces systèmes fournissent des primitives telles que :
- l'élection de leader
- les verrous distribués
- l'appartenance au cluster
- le stockage de configuration
Les applications peuvent alors construire des comportements de plus haut niveau par-dessus ces primitives.
Les systèmes distribués dans l'écosystème .NET
Bien que les outils d'infrastructure distribuée soient souvent associés à d'autres écosystèmes, les applications .NET opèrent de plus en plus dans des environnements distribués.
Les systèmes .NET modernes utilisent fréquemment :
- Kubernetes
- des caches distribués
- des microservices
- des architectures pilotées par les événements
En conséquence, la coordination et la gestion de l'état distribué deviennent de plus en plus importantes pour les développeurs .NET également.
En conclusion
Concevoir des systèmes distribués est fondamentalement différent de concevoir des applications mono-machine traditionnelles.
Les défis de la communication réseau, des défaillances partielles et de la cohérence des données introduisent des complexités qui exigent des modèles et une infrastructure spécialisés.
Heureusement, en comprenant les briques fondamentales — stockage, coordination, consensus et réplication — les développeurs peuvent concevoir des systèmes qui montent en charge de façon fiable et restent résilients face aux défaillances.
Dans de prochains articles, nous explorerons certaines de ces primitives plus en détail, notamment l'élection de leader, les modèles de coordination distribuée et les implémentations pratiques en .NET.