Zum Hauptinhalt springen

Von Redis kommend: Ihre .NET-App auf Zaris umstellen

· 5 Minuten Lesezeit
Clustron Team
Engineering für verteilte Systeme

Zwei Wege von Redis zu Zaris

Wenn Ihre .NET-Dienste bereits mit Redis kommunizieren, muss der Wechsel zu Zaris kein Rewrite sein. Zaris ist ein verteilter, replizierter In-Memory-Key/Value-Store, der nativ für .NET gebaut wurde — und seit 2.0.0 spricht er zwei Protokolle gleichzeitig: sein eigenes effizientes binäres Protokoll für erstklassige .NET-Clients und ein Redis-kompatibles RESP2-Frontend, auf das jeder Redis-Client in jeder Sprache zeigen kann.

Daraus ergeben sich zwei ehrliche Migrationspfade, die sich nicht gegenseitig ausschließen. Sie können mit dem RESP-Pfad ohne Änderungen beginnen, um Zaris heute unter Last zu bringen, und den nativen Client dort einführen, wo es sich lohnt. Dieser Beitrag geht beide Pfade durch und gibt Ihnen eine klare Regel für die Wahl an die Hand.

Zaris 0.9.0 ist da — und allgemein verfügbar

· 4 Minuten Lesezeit
Clustron Team
Engineering für verteilte Systeme

Zaris 0.9.0 — Allgemein verfügbar

Heute veröffentlichen wir Zaris 0.9.0 — und damit erreicht Zaris die allgemeine Verfügbarkeit. Es ist produktionsreif, plattformübergreifend und wird nun durch kommerziellen Support begleitet.

Falls Sie es noch nicht kennen: Zaris ist ein verteilter In-Memory-Key/Value-Store für .NET. Er ist schnell, repliziert und lässt sich über einen Browser, PowerShell oder direkt aus Ihrer Anwendung betreiben. Dieses Release ist der Höhepunkt dieser Arbeit — der Punkt, an dem aus einem „vielversprechenden Projekt“ etwas wird, das Sie in Produktion einsetzen können.

Reaktive Systeme mit Clustron Watch bauen

· 5 Minuten Lesezeit

Die meisten verteilten Systeme beginnen nicht kompliziert.

Sie beginnen mit etwas Einfachem — einer Schleife.

Sie schreiben einen kleinen Worker, der nach Arbeit sucht:

while (true)
{
var job = await client.GetAsync<Job>("jobs:next");

if (job.IsSuccess)
{
await ProcessAsync(job.Value);
}

await Task.Delay(1000);
}

In dieser Phase fühlt sich alles vernünftig an. Die Logik ist klar, das System verhält sich vorhersehbar, und der kognitive Aufwand ist gering.

Doch wenn das System wächst, wird dieses Muster unbemerkt zu einem der teuersten Teile Ihrer Architektur.


Die versteckten Kosten des Pollings in verteilten Systemen​

Polling bringt eine grundlegende Ineffizienz mit sich: Sie fragen das System wiederholt nach Änderungen, die in der Regel gar nicht eingetreten sind.

Mit zunehmender Skalierung gilt:

  • Mehrere Instanzen beginnen, dieselben Daten abzufragen
  • Jede Instanz führt wiederholt Lesezugriffe aus, von denen die meisten keine nützliche Information liefern
  • Sie führen künstliche Latenz ein — Änderungen werden erst im nächsten Polling-Zyklus erkannt
  • Das System verbraucht Ressourcen allein dafür, zu bestätigen, dass sich nichts geändert hat

Das Ergebnis ist ein System, das technisch korrekt, aber betrieblich ineffizient ist.

Noch wichtiger: Polling zwingt Sie zu Kompromissen, die Sie nicht eingehen sollten:

  • Häufig pollen → höhere Kosten, geringere Latenz
  • Seltener pollen → geringere Kosten, höhere Latenz

Es gibt keine richtige Antwort — nur Kompromisse.


Ein anderes Modell: Reagieren statt Nachfragen​

Die Alternative ist nicht bloß eine Optimierung — sie ist eine andere Denkweise über Systeme.

Statt zu fragen:

„Hat sich etwas geändert?“

entwerfen Sie Ihr System so, dass es auf die Aussage reagiert:

„Gerade hat sich etwas geändert.“

Das ist der Wechsel von einem Pull-basierten Modell zu einem Push-basierten Modell.

In Clustron wird dies über Watch umgesetzt.
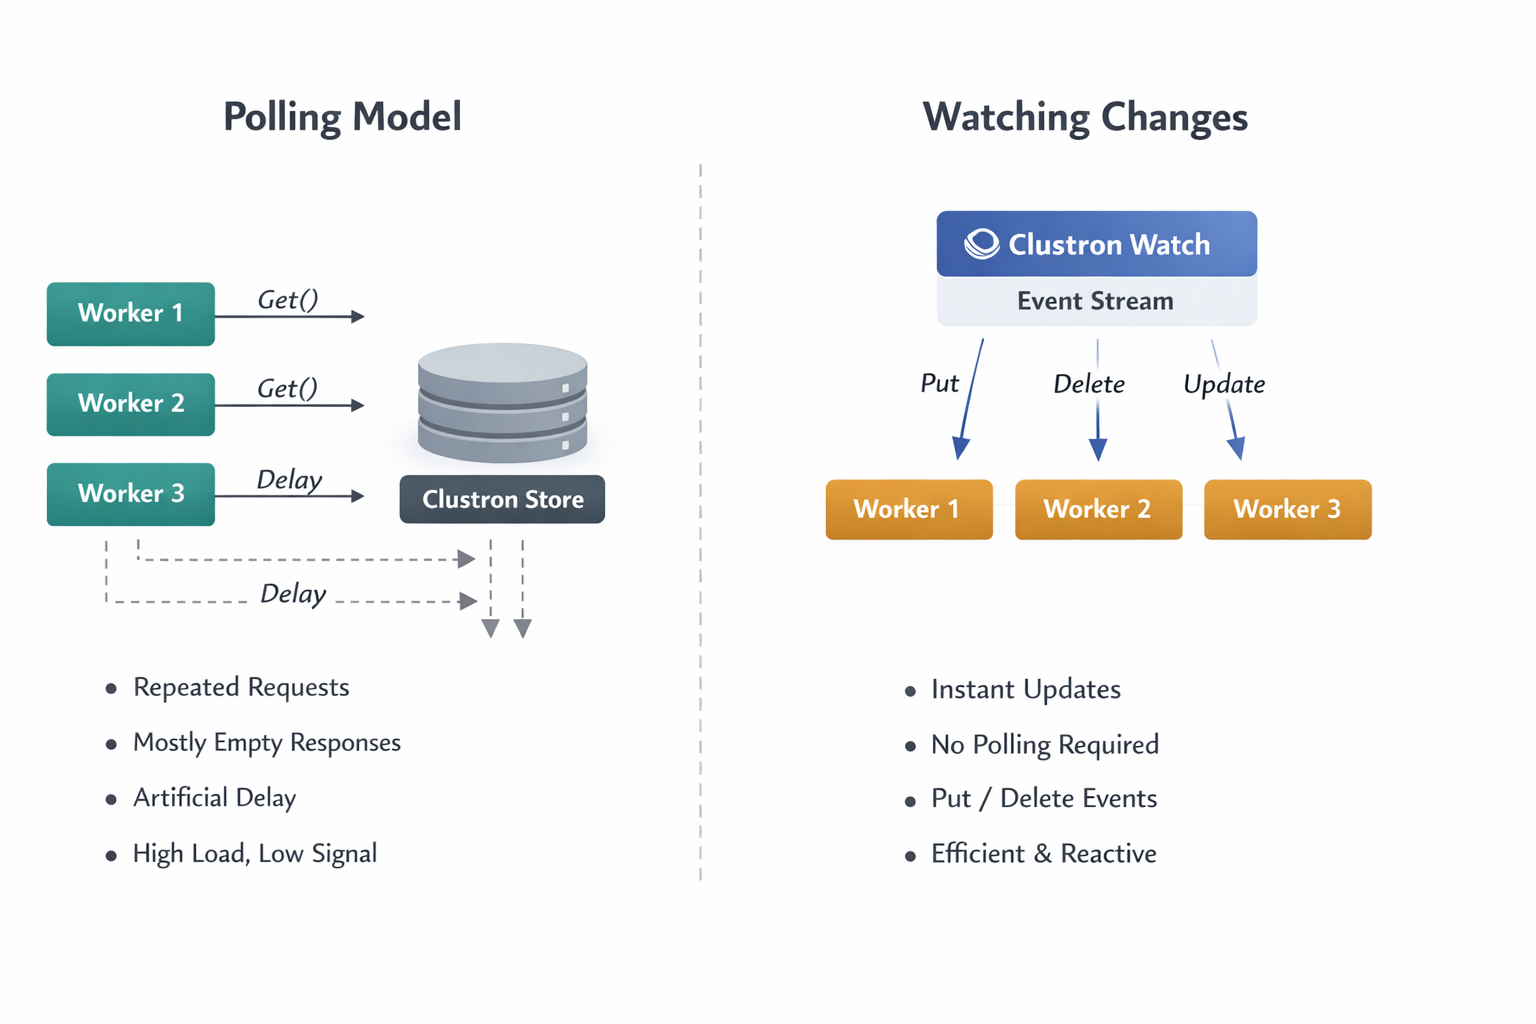

Polling-Modell vs. Beobachten von Änderungen


Watch im Überblick: Ein Strom von Zustandsänderungen​

Mit Clustron Watch abonnieren Sie Änderungen im System und erhalten Ereignisse, sobald sie eintreten.

Im Kern macht Watch aus Ihren Daten einen kontinuierlichen Strom von Aktualisierungen.

Einen einzelnen Key beobachten​

var (subscription, initialRecord) = await client.Watch.WatchKeyAsync(
"order:1001",
new WatchOptions { IncludeInitialSnapshot = true },
ev =>
{
Console.WriteLine($"{ev.EventType} → {ev.Key} = {ev.Value}");
});

Das leistet zwei wichtige Dinge:

  1. Sie erhalten den aktuellen Zustand (initialRecord)
  2. Sie abonnieren alle zukünftigen Änderungen

Diese Kombination ist entscheidend. Ohne sie müssten Sie den aktuellen Wert manuell abrufen und anschließend abonnieren — was Race Conditions mit sich bringt.


Snapshot + Streaming: Eine Korrektheitsgarantie​

Einer der subtilen, aber wesentlichen Aspekte von Watch ist die Möglichkeit, einen initialen Snapshot einzubeziehen.

Ist IncludeInitialSnapshot aktiviert:

  • erhalten Sie den aktuellen Wert zum Zeitpunkt des Abonnements
  • erhalten Sie anschließend alle weiteren Aktualisierungen in der richtigen Reihenfolge

Damit ist sichergestellt, dass:

  • Sie keinen bestehenden Zustand verpassen
  • Sie keine zukünftigen Änderungen verpassen
  • Sie keine zusätzliche Synchronisationslogik benötigen

Mit anderen Worten: Watch liefert eine vollständige und konsistente Sicht auf die Entwicklung des Zustands.


Collections beobachten: Über einzelne Keys hinaus​

Einen einzelnen Key zu beobachten ist nützlich, doch die meisten realen Systeme arbeiten mit Gruppen zusammengehöriger Daten.

Clustron unterstützt dies durch präfixbasiertes Beobachten:

var subscription = await client.Watch.WatchPrefixAsync(
"jobs:",
new WatchOptions { IncludeInitialSnapshot = false },
ev =>
{
Console.WriteLine($"Job update: {ev.Key}");
});

So können Sie alle Änderungen innerhalb einer logischen Gruppe beobachten.

Aus architektonischer Sicht wird Watch hier deutlich leistungsfähiger:

  • Sie reagieren nicht mehr auf einzelne Werte
  • Sie reagieren auf systemweite Zustandsübergänge

Das Ereignismodell verstehen​

Jede Änderung im System erzeugt ein WatchEvent.

Ein typisches Ereignis enthält:

  • den Key, der sich geändert hat
  • die Art der Änderung (Put oder Delete)
  • den neuen Wert (sofern zutreffend)
  • eine Revision, die die Version der Änderung darstellt

Diese Revision ist besonders wichtig. Sie liefert eine Reihenfolge und erlaubt es Ihnen, die Abfolge von Ereignissen über ein verteiltes System hinweg nachzuvollziehen.

Effektiv liefert Watch Ihnen ein Protokoll von Zustandsübergängen, in Echtzeit zugestellt.


Was das in der Praxis ermöglicht​

Sobald Sie dieses Modell übernehmen, werden mehrere häufige Probleme einfacher.

Job-Verarbeitung​

Statt nach neuer Arbeit zu pollen, reagieren Worker sofort, wenn Jobs angelegt oder aktualisiert werden.

Das beseitigt Leerlaufzyklen und senkt die Latenz.


Cache-Invalidierung​

Statt sich auf TTL oder periodische Aktualisierung zu verlassen, können Caches sich selbst als Reaktion auf tatsächliche Änderungen aktualisieren.

Das verbessert sowohl Aktualität als auch Effizienz.


Verteilte Koordination​

Systeme, die auf gemeinsamem Zustand beruhen — etwa Leader-Election oder Lease-Besitz —, profitieren erheblich von Echtzeit-Aktualisierungen.

Änderungen werden sofort weitergegeben, was eine schnellere und zuverlässigere Koordination ermöglicht.


Presence und Monitoring​

Aktive Komponenten zu verfolgen wird trivial:

  • Erscheint ein Node → erhalten Sie ein Ereignis
  • Verschwindet ein Node → erhalten Sie ein Ereignis

Kein Polling, kein Raten.


Betriebliche Aspekte​

Watch ist für langlaufende, ereignisgesteuerte Workloads konzipiert.

Einige wichtige Hinweise:

Handler schlank halten​

Ihr Event-Handler sollte keine aufwendige Arbeit direkt ausführen.

Stattdessen:

  • schnell verarbeiten
  • aufwendigere Aufgaben an Hintergrund-Worker delegieren

Lebenszyklus von Subscriptions verwalten​

Beenden Sie Subscriptions stets, wenn sie nicht mehr benötigt werden:

await subscription.StopAsync();

So werden Ressourcen sauber freigegeben.


Den Geltungsbereich verstehen​

  • Einen Key beobachten → nur dieser Key erzeugt Ereignisse
  • Ein Präfix beobachten → nur passende Keys erzeugen Ereignisse

Ereignisse sind eingegrenzt und isoliert, was unbeabsichtigtes Übersprechen zwischen Komponenten verhindert.


Von Polling-Schleifen zu reaktiven Systemen​

Der Wechsel vom Polling zum Beobachten betrifft nicht nur die Performance.

Er verändert die Struktur Ihrer Anwendung.

Polling-Systeme sind aufgebaut um:

Loop → Check → Wait → Repeat

Reaktive Systeme sind aufgebaut um:

Event → Handler → Action

Das Ergebnis sind Systeme, die:

  • reaktionsschneller sind
  • effizienter sind
  • leichter nachvollziehbar sind

Schlussgedanken​

Polling ist oft der einfachste Einstieg und funktioniert in kleinen Systemen gut genug.

Doch wenn Systeme wachsen, lassen sich die Kosten des Pollings immer schwerer rechtfertigen.

Clustron Watch bietet einen anderen Ansatz — einen, bei dem Ihr System auf Änderungen reagiert, statt nach ihnen zu suchen.

Stop asking your system if something changed.

Let it tell you when it does.

(Fragen Sie Ihr System nicht länger, ob sich etwas geändert hat. Lassen Sie es Ihnen sagen, wenn es so weit ist.)


Erste Schritte​

Probieren Sie ein einfaches Watch aus:

await client.Watch.WatchPrefixAsync("orders:", null, ev =>
{
Console.WriteLine($"{ev.Key} updated");
});

Beginnen Sie von dort aus, Polling-Schleifen zu entfernen — eine nach der anderen.

Sie werden schnell feststellen, dass Ihr System nicht nur schneller, sondern grundlegend einfacher wird.

Verteiltes Caching in .NET

· 4 Minuten Lesezeit

Caching ist eine der wirksamsten Methoden, die Performance einer Anwendung zu verbessern.
Die meisten .NET-Anwendungen beginnen mit einem einfachen In-Memory-Cache über MemoryCache oder IMemoryCache. Das funktioniert einwandfrei, solange die Anwendung auf einem einzelnen Server läuft.

Moderne Anwendungen laufen jedoch selten auf nur einem Rechner.

Skaliert eine Anwendung horizontal über mehrere Instanzen, funktioniert In-Memory-Caching nicht mehr zuverlässig. Jede Instanz führt ihren eigenen Cache, sodass der Anwendungszustand im Cluster inkonsistent wird.

Hier wird verteiltes Caching unverzichtbar.


Verteilter Cache


Das Problem mit In-Memory-Caches

Betrachten Sie eine typische ASP.NET-Anwendung hinter einem Load Balancer.

          Load Balancer
|
---------------------------
| | |
Server A Server B Server C

Jeder Server hat seinen eigenen Memory-Cache.

Aktualisiert ein Request zwischengespeicherte Daten auf Server A, bleiben die Caches auf Server B und Server C veraltet.

Das führt zu mehreren Problemen:

  • inkonsistenter Anwendungszustand
  • veraltete Cache-Einträge
  • doppeltes Cache-Warmup
  • unvorhersehbares Verhalten

Um dieses Problem zu lösen, muss der Cache von allen Nodes gemeinsam genutzt werden.


Was ist ein verteilter Cache?

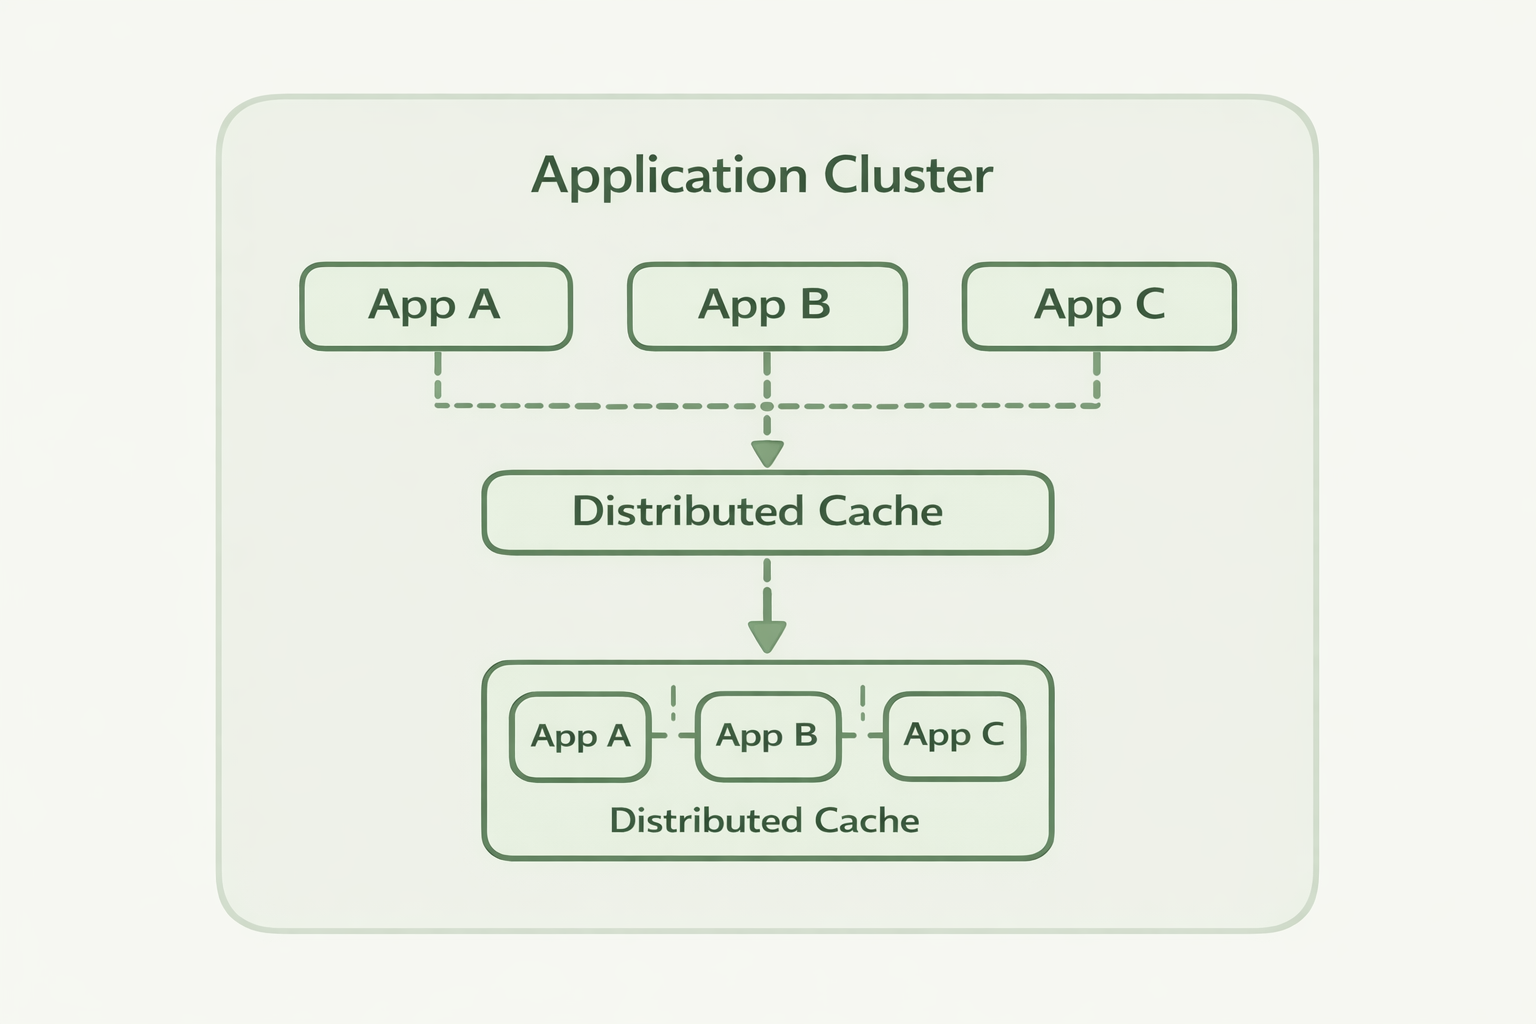
Ein verteilter Cache ist ein zentraler oder geclusterter Cache, auf den mehrere Anwendungsinstanzen zugreifen können.

Statt zwischengespeicherte Daten im Anwendungsprozess abzulegen, werden sie in einem verteilten Key/Value-Store gespeichert.

           Application Nodes

App A App B App C
| | |
+---------+---------+
|
Distributed Cache

Alle Anwendungs-Nodes lesen und schreiben Cache-Einträge im selben verteilten Store.

Das gewährleistet:

  • konsistente zwischengespeicherte Daten
  • gemeinsam genutzten Anwendungszustand
  • bessere Skalierbarkeit

Einfaches Beispiel für einen verteilten Cache in .NET

Ein verteilter Cache wird typischerweise über eine Abstraktion wie IDistributedCache verwendet.

Beispiel:

public class ProductService
{
private readonly IDistributedCache _cache;

public ProductService(IDistributedCache cache)
{
_cache = cache;
}

public async Task<string?> GetProductAsync(string id)
{
var cached = await _cache.GetStringAsync(id);

if (cached != null)
return cached;

var product = await LoadProductFromDatabase(id);

await _cache.SetStringAsync(id, product);

return product;
}

private Task<string> LoadProductFromDatabase(string id)
{
return Task.FromResult($"Product {id}");
}
}

Die Anwendung prüft zuerst den Cache. Fehlt der Wert, werden die Daten aus der Datenbank geladen und anschließend im Cache abgelegt.

Dieses Muster heißt Cache-Aside-Caching.


Gängige Lösungen für verteilte Caches

Mehrere Technologien bieten verteilte Caching-Funktionen.

Redis​

Redis ist einer der am häufigsten eingesetzten verteilten Caches.

Es bietet:

  • Key/Value-Speicherung
  • hohe Performance
  • In-Memory-Operationen

Für die verteilte Koordination benötigt Redis jedoch oft zusätzliche Komponenten.


Datenbankgestützte Caches​

Manche Anwendungen nutzen relationale Datenbanken als Cache.

Das ist zwar einfach, bringt aber:

  • Datenbank-Contention
  • geringere Performance
  • eingeschränkte Skalierbarkeit

Verteilte Key/Value-Plattformen​

Moderne verteilte Systeme nutzen häufig verteilte Key/Value-Plattformen, die sowohl Caching- als auch Koordinationsprimitive bereitstellen.

Diese Systeme unterstützen:

  • verteiltes Caching
  • verteilte Locks
  • Leader-Election
  • Änderungsbenachrichtigungen
  • Cluster-Koordination

Clustron als verteilten Cache verwenden

Clustron bietet eine verteilte Key/Value-Plattform, die für .NET- Anwendungen entwickelt wurde.

Da sie als verteilter Cluster läuft, greifen alle Anwendungsinstanzen auf denselben gemeinsamen Datenspeicher zu.

Beispiel:

using Clustron.DKV.Client;

var client = await DKVClient.InitializeRemote(
"teststore",
new[]
{
new DkvServerInfo("localhost", 7861)
});

await client.PutAsync("product:1", "Laptop");

var value = await client.GetAsync<string>("product:1");

Console.WriteLine(value);

In diesem Beispiel gilt:

  • Anwendungs-Nodes verbinden sich mit dem Cluster
  • Daten werden im verteilten Store gespeichert
  • alle Nodes sehen dieselben Daten

So bleibt der Cache im gesamten Cluster konsistent.


Wann verteiltes Caching sinnvoll ist

Verteiltes Caching ist besonders nützlich in Systemen, die:

  • mehrere Anwendungsinstanzen betreiben
  • hohe Request-Volumina verarbeiten
  • stark auf Datenbank-Lesezugriffe angewiesen sind
  • gemeinsamen Anwendungszustand benötigen

Typische Anwendungsfälle sind:

  • ASP.NET-Webanwendungen
  • Microservice-Architekturen
  • Systeme zur Hintergrundverarbeitung
  • API-Plattformen

Zusammenfassung

In-Memory-Caching eignet sich gut für Anwendungen auf einem einzelnen Server, doch moderne verteilte Systeme benötigen eine gemeinsame Caching-Schicht.

Verteiltes Caching erlaubt es mehreren Anwendungsinstanzen, dieselben zwischengespeicherten Daten zu nutzen, und verbessert so Skalierbarkeit und Konsistenz.

Plattformen wie Clustron stellen einen verteilten Key/Value-Store bereit, der verteiltes Caching und Koordination in .NET-Anwendungen einfach umsetzbar macht.

Leader-Election in verteilten Systemen

· 4 Minuten Lesezeit

Wenn Anwendungen über mehrere Rechner skalieren, wird die Koordination zu einem der schwierigsten Probleme.
Verteilte Systeme betreiben oft mehrere identische Nodes, die alle dieselbe Arbeit verrichten können. Ohne Koordination versuchen diese Nodes möglicherweise gleichzeitig dieselbe Aufgabe auszuführen, was zu doppelter Arbeit, Race Conditions oder inkonsistentem Zustand führt.

Eine der gängigsten Methoden, dieses Problem zu lösen, ist die Leader-Election.

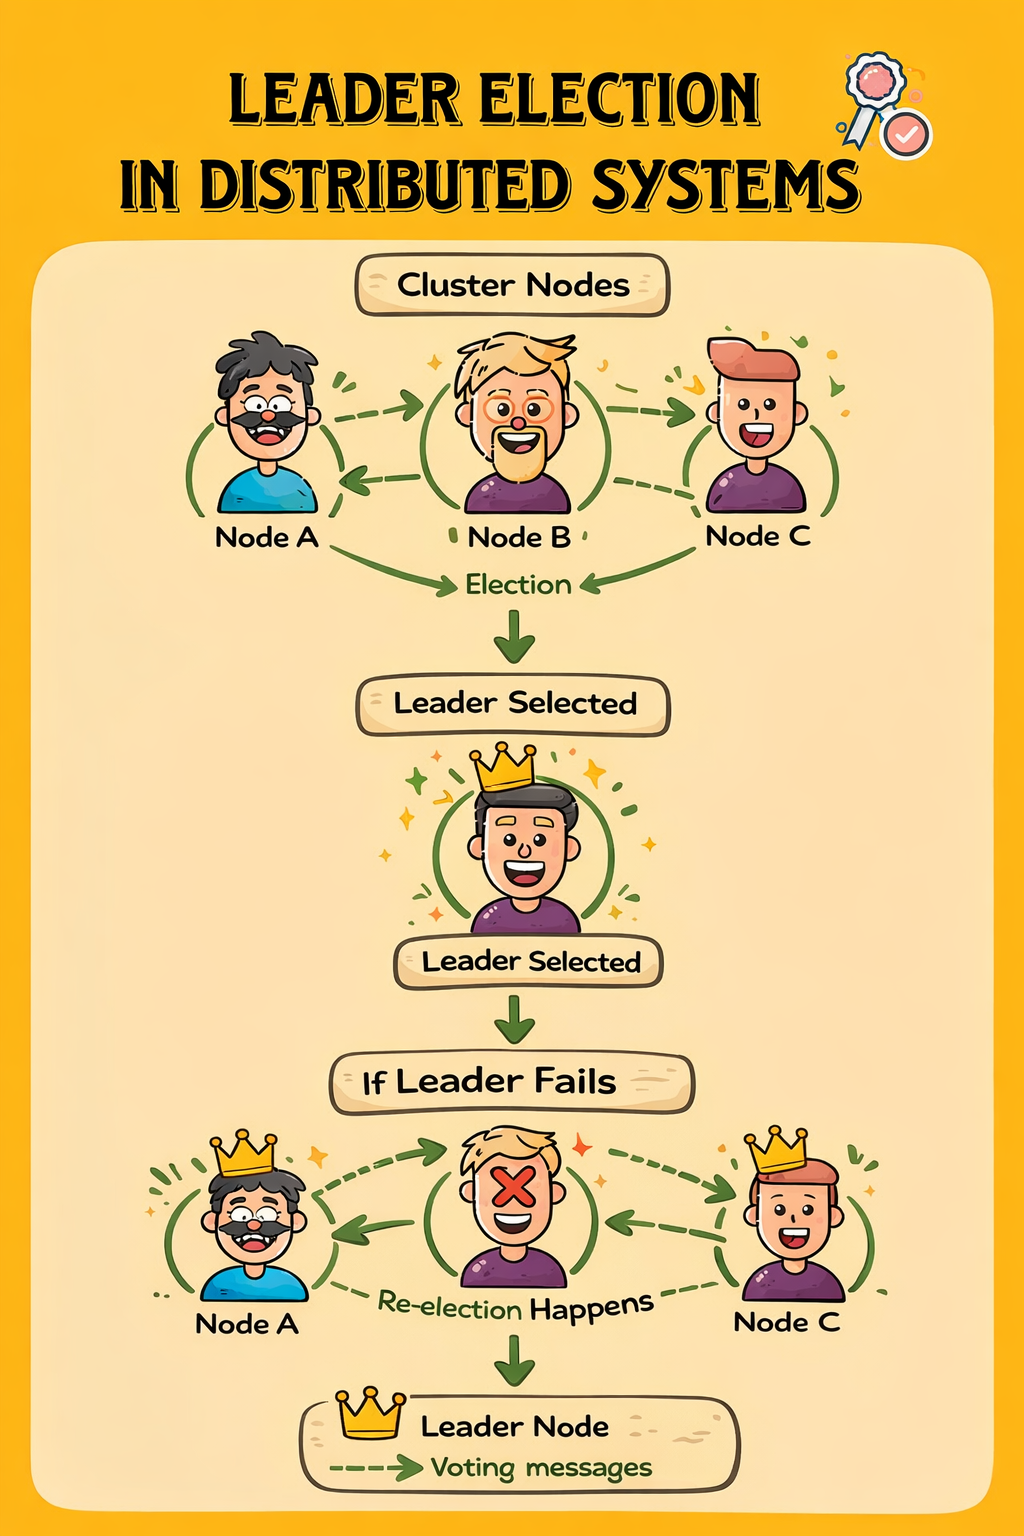
Die Leader-Election stellt sicher, dass ein Node vorübergehend zum Leader wird, während die übrigen Nodes Follower bleiben. Der Leader übernimmt Koordinationsaufgaben, während die Follower auf einen Wechsel der Führung warten.

Dieses Muster wird breit eingesetzt in verteilten Datenbanken, Job-Schedulern, Container-Orchestrierungsplattformen und Konfigurationssystemen.


Leader-Election in verteilten Systemen


Ein einfaches Beispiel

Stellen Sie sich ein verteiltes Worker-System mit drei Nodes vor:

Worker A Worker B Worker C

Jeder Worker kann Hintergrundjobs ausführen.

Führen alle Worker denselben geplanten Job aus, läuft er dreimal.
Stattdessen soll genau ein Worker den Job ausführen.

Hier kommt die Leader-Election ins Spiel. Ein Worker wird zum Leader, und nur der Leader führt den Job aus.


Das einfachste Leader-Election-Muster

Ein gängiger Ansatz nutzt einen gemeinsamen Koordinations-Store.

Die Idee ist einfach:

  1. Jeder Node versucht, die Führung zu übernehmen.
  2. Der Node, dem das gelingt, wird zum Leader.
  3. Der Leader erneuert seine Führung regelmäßig.
  4. Fällt der Leader aus, übernimmt ein anderer Node.

Typischerweise wird dies mit einem Lease umgesetzt.

Ein Lease funktioniert wie ein Lock mit Ablaufzeit. Verschwindet der Node, der den Lease hält, kann ein anderer Node die Führung gefahrlos übernehmen.


Ein minimales .NET-Beispiel

Das folgende vereinfachte Beispiel zeigt die Idee hinter Lease-basierter Führung.

public class LeaderElection
{
private readonly ILeaseStore _store;
private readonly string _nodeId;

public LeaderElection(ILeaseStore store, string nodeId)
{
_store = store;
_nodeId = nodeId;
}

public async Task RunAsync()
{
while (true)
{
var acquired = await _store.TryAcquireLeaseAsync("cluster-leader", _nodeId, TimeSpan.FromSeconds(10));

if (acquired)
{
Console.WriteLine($"{_nodeId} is leader");

await PerformLeaderWork();

await _store.RenewLeaseAsync("cluster-leader", _nodeId);
}

await Task.Delay(2000);
}
}

private Task PerformLeaderWork()
{
Console.WriteLine("Running scheduled tasks...");
return Task.CompletedTask;
}
}

In diesem Beispiel gilt:

  • Jeder Node versucht, den Lease "cluster-leader" zu erwerben.
  • Der Node, dem das gelingt, wird zum Leader.
  • Der Leader erneuert den Lease regelmäßig.
  • Stürzt der Leader ab, läuft der Lease ab, und ein anderer Node übernimmt.

Dieses Muster bietet automatisches Failover.


Probleme bei selbstgebauter Leader-Election

Obwohl das obige Beispiel einfach aussieht, bringen reale verteilte Systeme Komplikationen mit sich:

Netzwerkpartitionen können dazu führen, dass Nodes glauben, noch Leader zu sein.

Clock Drift kann Probleme beim Ablauf von Leases verursachen.

Eine langsame Fehlererkennung kann den Wechsel der Führung verzögern.

Einen robusten Leader-Election-Mechanismus zu bauen, erfordert den sorgfältigen Umgang mit den Randfällen verteilter Systeme.

Deshalb setzen viele Systeme auf spezialisierte Koordinationsplattformen wie:

  • etcd
  • ZooKeeper
  • Consul

Diese Systeme implementieren zuverlässige Koordinationsprimitive.


Leader-Election mit Clustron

Clustron bietet eine Clustering-Plattform für verteilte Systeme in .NET.

Statt Koordinationsinfrastruktur selbst zu bauen, können Anwendungen die integrierten Primitive der Plattform nutzen.

Beispiel mit dem Lease-Konzept von Clustron:

using Clustron.DKV.Client;

var client = await DKVClient.InitializeRemote(
"teststore",
new[] { new DkvServerInfo("localhost", 7861) });

var lease = await client.GrantLeaseAsync(TimeSpan.FromSeconds(10));

if (lease.Acquired)
{
Console.WriteLine("This node is the leader.");

while (true)
{
await client.RefreshLeaseAsync(lease.Id);
await Task.Delay(3000);
}
}

Hier fordert der Node einen Lease vom Cluster an.

Wird der Lease gewährt, wird der Node zum Leader.
Solange der Node den Lease aktualisiert, bleibt die Führung gültig.

Stürzt der Node ab oder erneuert er den Lease nicht mehr, kann ein anderer Node die Führung automatisch übernehmen.


Wann Leader-Election nützlich ist

Leader-Election tritt in vielen realen verteilten Systemen auf:

  • Verteilte Job-Scheduler
  • Verarbeitung von Hintergrundaufgaben
  • Cluster-Manager
  • Koordination von Microservices
  • Konfigurations-Controller

Immer wenn ein System genau einen Node zur Koordination der Aktivitäten benötigt, wird die Leader-Election unverzichtbar.


Zusammenfassung

Die Leader-Election ist ein grundlegender Baustein verteilter Systeme.

Sie ermöglicht es Node-Clustern, ihr Verhalten zu koordinieren und dabei Hochverfügbarkeit zu wahren.

Ein Lease-basierter Ansatz bietet eine einfache und wirksame Implementierungsstrategie, und verteilte Plattformen wie Clustron stellen diese Primitive direkt für .NET-Anwendungen bereit.

Statt Koordinationslogik von Grund auf zu bauen, können sich Entwickler auf das Anwendungsverhalten konzentrieren, während die Clustering-Plattform Führung, Failover und Koordination übernimmt.

Verteilte Locks erklärt

· 4 Minuten Lesezeit
Clustron Team
Engineering für verteilte Systeme

Ein praktischer Leitfaden für .NET-Entwickler

Einleitung​

Wenn Anwendungen über mehrere Rechner skalieren, wird die Koordination zu einem der schwierigsten Aspekte des Systementwurfs.

In einer Anwendung auf einem einzelnen Rechner ist gegenseitiger Ausschluss unkompliziert. Entwickler können sich auf Sprachprimitive wie lock in C#, Mutex oder Semaphore verlassen, um sicherzustellen, dass jeweils nur ein Thread auf eine gemeinsame Ressource zugreift.

Diese Primitive funktionieren jedoch nur innerhalb eines einzelnen Prozesses oder Rechners.

Sobald Anwendungen über mehrere Dienste oder Nodes laufen, greifen klassische Locking-Mechanismen nicht mehr. Zwei Dienste auf verschiedenen Rechnern können sich nicht auf eine lokale lock-Anweisung stützen, um den Zugriff auf gemeinsamen Zustand zu koordinieren.

Hier werden verteilte Locks unverzichtbar.

Verteilte Locks erlauben es Diensten in einem Cluster, den Zugriff auf gemeinsame Ressourcen zu koordinieren und dabei sicherzustellen, dass zu einem gegebenen Zeitpunkt nur ein Teilnehmer den Lock hält.


Lokale Locks vs. verteilte Locks​

Ein typischer lokaler Lock in C# sieht so aus:

private static readonly object _lock = new object();

public void ProcessOrder()
{
lock(_lock)
{
Console.WriteLine("Processing order safely.");
}
}

Das funktioniert einwandfrei innerhalb eines einzelnen Prozesses.

Läuft Ihre Anwendung jedoch auf mehreren Dienstinstanzen, besitzt jede Instanz ihr eigenes _lock-Objekt. Der Lock koordiniert die Arbeit nicht mehr über das gesamte System.

Worker A → lock acquired Worker B → lock acquired Worker C → lock acquired

Alle Worker fahren gleichzeitig fort, womit der Zweck des Lockings verfehlt ist.

Verteilte Systeme benötigen einen gemeinsamen Koordinationsmechanismus.


Verteiltes Locking


Die Idee hinter verteilten Locks​

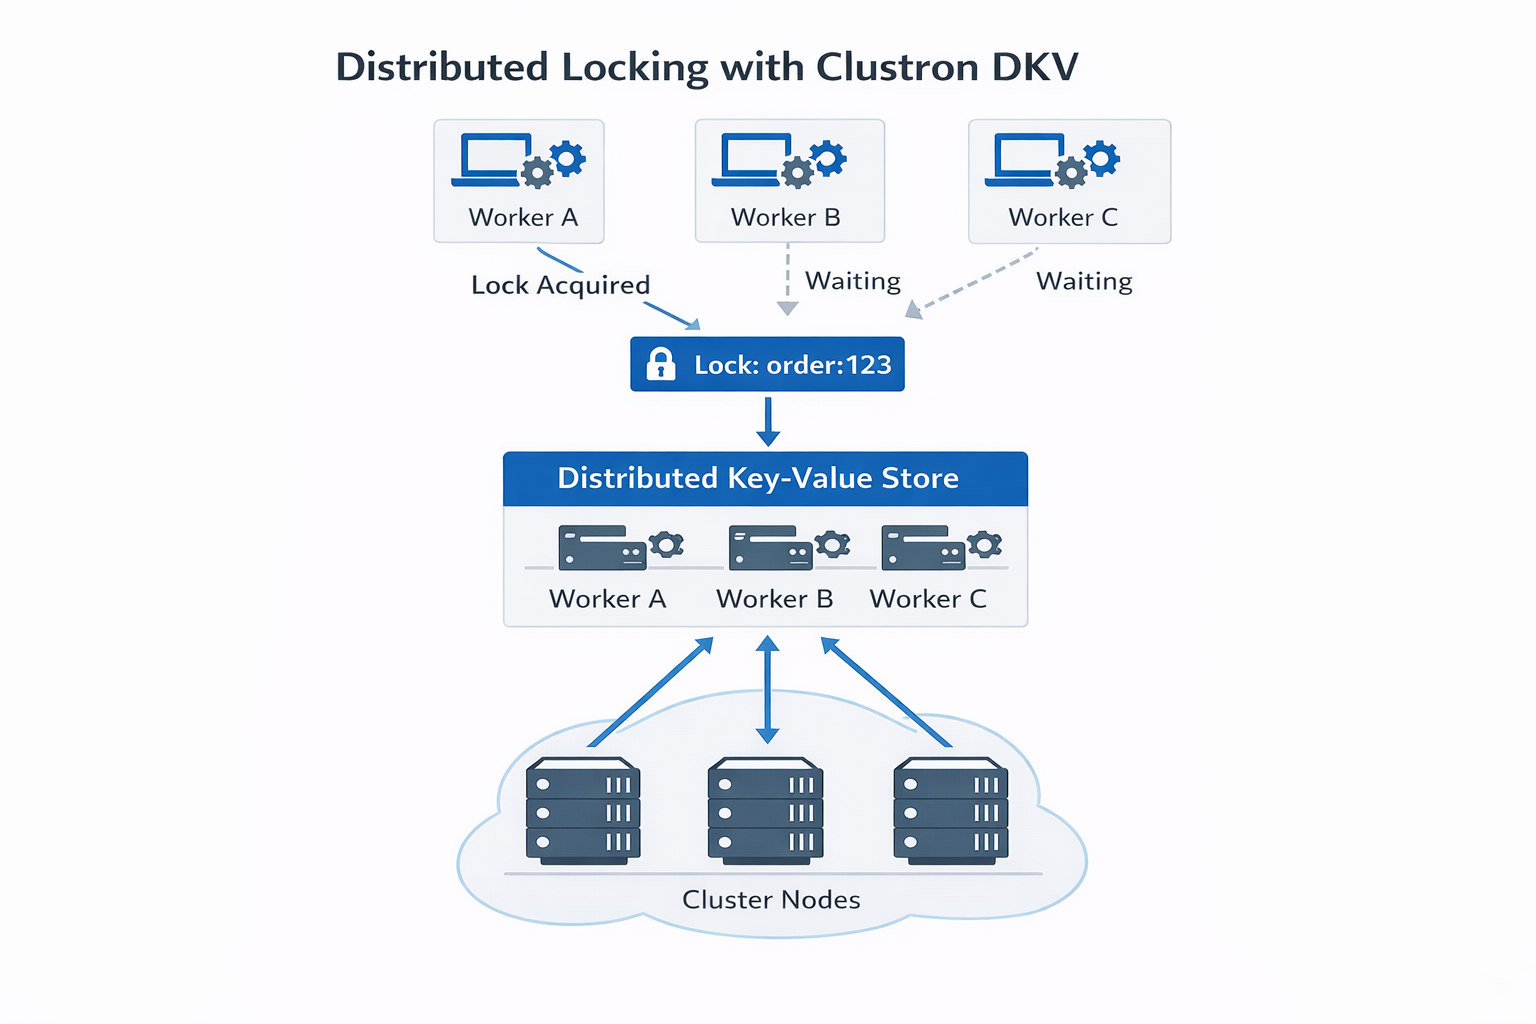
Ein verteilter Lock nutzt ein gemeinsames System, um den Besitz des Locks abzubilden.

Statt Speicher zu sperren, hält ein Node den Lock-Besitz in einem verteilten Koordinationssystem fest, zum Beispiel in:

  • einem verteilten Key/Value-Store
  • einem Koordinationsdienst
  • einem verteilten Cache

Beispielkonzept:

Lock Key: order:123 Owner: worker‑1

Versucht ein anderer Worker, denselben Lock zu erwerben, schlägt die Operation fehl, bis der Lock freigegeben wird oder abläuft.


Praxisszenario: Verteilte Rechnungsverarbeitung​

Stellen Sie sich einen Cluster von Workern vor, die Rechnungen verarbeiten.

Worker A Worker B Worker C

Alle Worker suchen nach offenen Rechnungen.

Ohne Locking:

Worker A → processes invoice #101 Worker B → processes invoice #101 Worker C → processes invoice #101

Dieselbe Rechnung könnte mehrfach verarbeitet werden.

Ein verteilter Lock stellt sicher, dass nur ein Worker die Rechnung verarbeitet.


Verteilte Locks mit Clustron DKV​

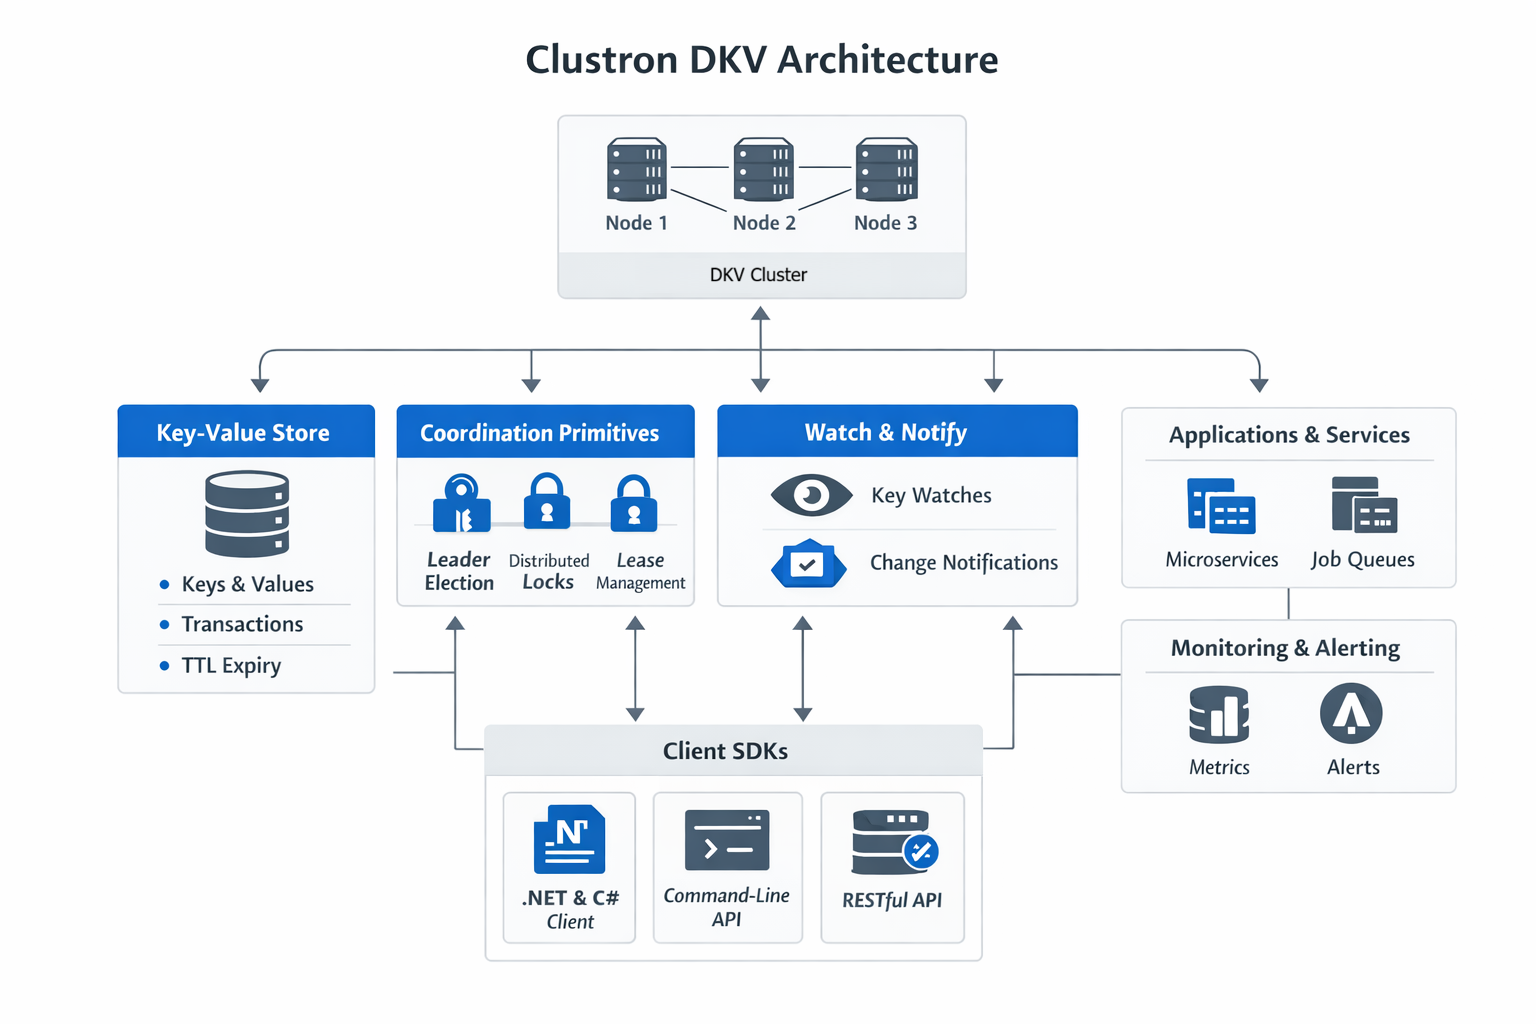
Clustron DKV bietet integrierte Primitive für die verteilte Koordination.

Locks werden über die Locks API verwaltet, und Operationen auf gesperrten Keys müssen das korrekte Lock-Handle enthalten.


Einen Lock erwerben​

Ein Client erwirbt zunächst einen Lock für einen bestimmten Key.

var locks = ((IDkv)client).Locks;

var key = "order:123";

var lockHandle = await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

if (lockHandle == null)
{
Console.WriteLine("Failed to acquire lock.");
return;
}

Console.WriteLine("Lock acquired.");

Das zurückgegebene Lock-Handle repräsentiert den Besitz des Locks.


Operationen unter dem Lock ausführen​

Sobald ein Lock erworben wurde, müssen Operationen das Lock-Handle enthalten.

var result = await client.PutAsync(
key,
"processed",
Put.WithLock(lockHandle.Handle));

if (result.IsSuccess)
{
Console.WriteLine("Value updated safely.");
}

Nur der Lock-Besitzer kann den Wert ändern.


Lesen mit dem Lock​

Auch Lesezugriffe können den Lock-Besitz berücksichtigen.

var value = await client.GetAsync<string>(
key,
Get.WithLock(lockHandle.Handle));

if (value.IsSuccess)
{
Console.WriteLine($"Value: {value.Value}");
}

Konkurrierende Operationen ohne den Lock​

Versucht ein anderer Worker, den Key ohne den Lock zu ändern, schlägt die Operation fehl.

var attempt = await client.PutAsync(key, "new-value");

if (!attempt.IsSuccess)
{
Console.WriteLine($"Operation rejected: {attempt.Status}");
}

Ergebnis:

KvStatus.Locked

Dies verhindert die gleichzeitige Änderung derselben Ressource.


Den Lock freigeben​

Ist die Arbeit abgeschlossen, kann der Lock freigegeben werden.

await lockHandle.ReleaseAsync();

Console.WriteLine("Lock released.");

Nach der Freigabe kann ein anderer Worker den Lock erwerben.


Beispielhafter Cluster-Ablauf​

Worker A → Acquire Lock → Success Worker B → Acquire Lock → Failed Worker C → Acquire Lock → Failed

Worker A → Update Key Worker A → Release Lock

Nur ein Worker führt die Operation aus, was die Korrektheit sicherstellt.


Umgang mit Ausfällen​

Locks in Clustron sind zeitlich begrenzt.

Beim Erwerb eines Locks muss eine Dauer angegeben werden:

await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

Stürzt der Client, der den Lock hält, ab oder bricht die Verbindung ab, läuft der Lock schließlich ab, sodass ein anderer Worker ihn erwerben kann.

Dadurch bleiben Locks nicht dauerhaft gehalten.


Best Practices​

Bei der Implementierung verteilter Locks:

  • Halten Sie kritische Abschnitte kurz
  • Vermeiden Sie nach Möglichkeit globale Locks
  • Partitionieren Sie Locks nach Ressource
  • Planen Sie stets für Fehlerszenarien

Schlussgedanken​

Verteilte Locks gehören zu den grundlegendsten Koordinationsprimitiven in verteilten Systemen.

Sie erlauben es Diensten auf mehreren Rechnern, den Zugriff auf gemeinsame Ressourcen sicher zu koordinieren und dabei die Korrektheit des Systems zu wahren.

Plattformen wie Clustron DKV vereinfachen dies durch integrierte Locking-Primitive, atomare Operationen und starke Konsistenzgarantien.

Im nächsten Artikel betrachten wir ein weiteres essenzielles Primitiv verteilter Systeme:

Leader-Election.

Verteilte Systeme entwickeln

· 4 Minuten Lesezeit
Clustron Team
Engineering für verteilte Systeme

Ein praktischer Leitfaden für .NET-Entwickler

Einleitung​

Die meisten Backend-Systeme beginnen ihr Leben auf einem einzelnen Rechner.

Eine ASP.NET-Core-Anwendung verarbeitet Requests, eine Datenbank speichert die Anwendungsdaten, und Hintergrundprozesse übernehmen asynchrone Aufgaben wie den Versand von E-Mails oder die Erstellung von Berichten. In dieser Umgebung ist Nebenläufigkeit beherrschbar, und die Koordination zwischen den Komponenten ist vergleichsweise einfach.

Wächst das System jedoch, ändert sich das.

Der Traffic nimmt zu, mehr Anwendungsinstanzen werden hinter einem Load Balancer betrieben, und Dienste laufen auf mehreren Rechnern. Aus der einstigen Einzelanwendung wird ein verteiltes System.

An diesem Punkt ändert sich die Natur des Problems grundlegend.

Die Herausforderungen beschränken sich nicht mehr darauf, korrekte Geschäftslogik zu schreiben. Entwickler müssen sich nun mit der Koordination über Rechnergrenzen hinweg, mit Netzwerkausfällen, Teilausfällen und der Wahrung der Konsistenz über verteilten Zustand befassen.

Hier beginnt die Ingenieurdisziplin der verteilten Systeme.


Architektur verteilter Systeme


Was ist ein verteiltes System?​

Ein verteiltes System ist eine Menge unabhängiger Computer, die dem Benutzer als ein einziges, in sich geschlossenes System erscheinen.

Statt die gesamte Logik auf einem Rechner auszuführen, werden Verantwortlichkeiten auf mehrere Nodes verteilt, die über das Netzwerk kommunizieren.

Beispiele sind:

  • Microservice-Architekturen
  • Verteilte Datenbanken
  • Geclusterte Caches
  • Message Queues
  • Cloud-Infrastrukturplattformen

Diese Systeme bieten Skalierbarkeit und Ausfallsicherheit, bringen aber neue Komplexität mit sich.


Warum verteilte Systeme schwierig sind​

Anders als eine Anwendung auf einem einzelnen Rechner müssen verteilte Systeme mit Gegebenheiten wie den folgenden umgehen:

Netzwerkausfälle​

In verteilten Systemen findet die Kommunikation über ein Netzwerk statt. Netzwerke können langsam, unzuverlässig oder zeitweise nicht verfügbar sein.

Ein Request kann fehlschlagen, weil der entfernte Node abgestürzt ist, weil das Netzwerk Pakete verworfen hat oder weil ein Timeout aufgetreten ist.

Das System muss solche Szenarien kontrolliert abfangen.


Teilausfälle​

In einem verteilten System können Komponenten unabhängig voneinander ausfallen.

Ein Node in einem Cluster kann abstürzen, während die anderen gesund bleiben. Eine Dienstinstanz kann neu starten, während andere Dienste weiterlaufen.

Das bedeutet, dass das System auch dann korrekt arbeiten muss, wenn nur ein Teil davon funktioniert.


Herausforderungen bei der Konsistenz​

Werden Daten über mehrere Nodes hinweg repliziert, wird es schwierig, sie konsistent zu halten.

Zum Beispiel:

  • Zwei Nodes können versuchen, dieselben Daten gleichzeitig zu aktualisieren.
  • Netzwerkverzögerungen können dazu führen, dass sich Nodes vorübergehend nicht über den aktuellen Zustand einig sind.
  • Ein Node kann abstürzen, nachdem er nur einen Teil einer Operation ausgeführt hat.

Systeme, die trotz dieser Szenarien einen konsistenten Zustand wahren, erfordern eine sorgfältige Koordination.


Zentrale Bausteine verteilter Systeme​

Die meisten verteilten Systeme stützen sich auf einige wenige Kernprimitive.

Wer diese Primitive versteht, kann zuverlässige Architekturen besser entwerfen.


Verteilter Speicher​

Daten müssen häufig auf mehrere Rechner verteilt gespeichert werden.

Das ermöglicht:

  • horizontale Skalierung
  • Fehlertoleranz
  • Hochverfügbarkeit

Hierfür werden üblicherweise verteilte Key/Value-Stores eingesetzt.


Koordination​

Nodes müssen Aktionen wie die folgenden koordinieren:

  • Leader-Election
  • verteiltes Locking
  • Cluster-Mitgliedschaft
  • Konfigurationsänderungen

Ohne Koordinationsmechanismen könnten mehrere Nodes widersprüchliche Operationen ausführen.


Konsens​

Manche Systeme benötigen starke Garantien für den gemeinsamen Zustand.

Konsensalgorithmen wie Raft oder Paxos ermöglichen es Nodes, sich auch bei Ausfällen auf Entscheidungen zu einigen.

Diese Algorithmen sind grundlegend für verteilte Datenbanken und Koordinationsdienste.


Partitionierung und Replikation​

Daten werden typischerweise:

  • über Nodes hinweg partitioniert, um die Last zu verteilen
  • repliziert, um sich gegen Ausfälle abzusichern

Performance, Verfügbarkeit und Konsistenz auszubalancieren, ist eine der zentralen Entwurfsherausforderungen.


Gängige Muster verteilter Systeme​

Mehrere Muster tauchen in realen Systemen immer wieder auf.

Beispiele:

  • Leader-Election zur Koordination von Cluster-Aktivitäten
  • Verteilte Locks zur Sicherstellung des gegenseitigen Ausschlusses
  • Job-Queues für die asynchrone Verarbeitung
  • Rate Limiter zur Steuerung des Request-Volumens
  • Transaktionsprotokolle für atomare Aktualisierungen über mehrere Nodes

Diese Muster bilden das Fundament vieler großer Plattformen.


Die Rolle von Koordinationssystemen​

Um die Entwicklung verteilter Systeme zu vereinfachen, setzen viele Organisationen auf Koordinationssysteme wie:

  • etcd
  • ZooKeeper
  • Consul

Diese Systeme stellen Primitive bereit wie:

  • Leader-Election
  • verteilte Locks
  • Cluster-Mitgliedschaft
  • Konfigurationsspeicher

Anwendungen können darauf aufbauend Verhalten auf höherer Ebene umsetzen.


Verteilte Systeme im .NET-Ökosystem​

Während verteilte Infrastrukturwerkzeuge oft mit anderen Ökosystemen in Verbindung gebracht werden, laufen .NET-Anwendungen zunehmend in verteilten Umgebungen.

Moderne .NET-Systeme nutzen häufig:

  • Kubernetes
  • verteilte Caches
  • Microservices
  • ereignisgesteuerte Architekturen

Dadurch gewinnen Koordination und die Verwaltung von verteiltem Zustand auch für .NET-Entwickler zunehmend an Bedeutung.


Schlussgedanken​

Verteilte Systeme zu bauen, unterscheidet sich grundlegend vom Bau klassischer Anwendungen auf einem einzelnen Rechner.

Netzwerkkommunikation, Teilausfälle und Datenkonsistenz bringen Komplexität mit sich, die spezialisierte Muster und Infrastruktur erfordert.

Wer die zentralen Bausteine versteht — Speicher, Koordination, Konsens und Replikation —, kann glücklicherweise Systeme entwerfen, die zuverlässig skalieren und auch bei Ausfällen widerstandsfähig bleiben.

In kommenden Artikeln beleuchten wir einige dieser Primitive genauer, darunter Leader-Election, Koordinationsmuster für verteilte Systeme und praktische Implementierungen in .NET.