Verteiltes Caching in .NET
Caching ist eine der wirksamsten Methoden, die Performance einer
Anwendung zu verbessern.
Die meisten .NET-Anwendungen beginnen mit einem einfachen
In-Memory-Cache über MemoryCache oder IMemoryCache. Das funktioniert
einwandfrei, solange die Anwendung auf einem einzelnen Server läuft.
Moderne Anwendungen laufen jedoch selten auf nur einem Rechner.
Skaliert eine Anwendung horizontal über mehrere Instanzen, funktioniert In-Memory-Caching nicht mehr zuverlässig. Jede Instanz führt ihren eigenen Cache, sodass der Anwendungszustand im Cluster inkonsistent wird.
Hier wird verteiltes Caching unverzichtbar.
Das Problem mit In-Memory-Caches
Betrachten Sie eine typische ASP.NET-Anwendung hinter einem Load Balancer.
          Load Balancer
                |
     ---------------------------
     |            |            |
  Server A     Server B     Server C
Jeder Server hat seinen eigenen Memory-Cache.
Aktualisiert ein Request zwischengespeicherte Daten auf Server A, bleiben die Caches auf Server B und Server C veraltet.
Das führt zu mehreren Problemen:
- inkonsistenter Anwendungszustand
- veraltete Cache-Einträge
- doppeltes Cache-Warmup
- unvorhersehbares Verhalten
Um dieses Problem zu lösen, muss der Cache von allen Nodes gemeinsam genutzt werden.
Was ist ein verteilter Cache?
Ein verteilter Cache ist ein zentraler oder geclusterter Cache, auf den mehrere Anwendungsinstanzen zugreifen können.
Statt zwischengespeicherte Daten im Anwendungsprozess abzulegen, werden sie in einem verteilten Key/Value-Store gespeichert.
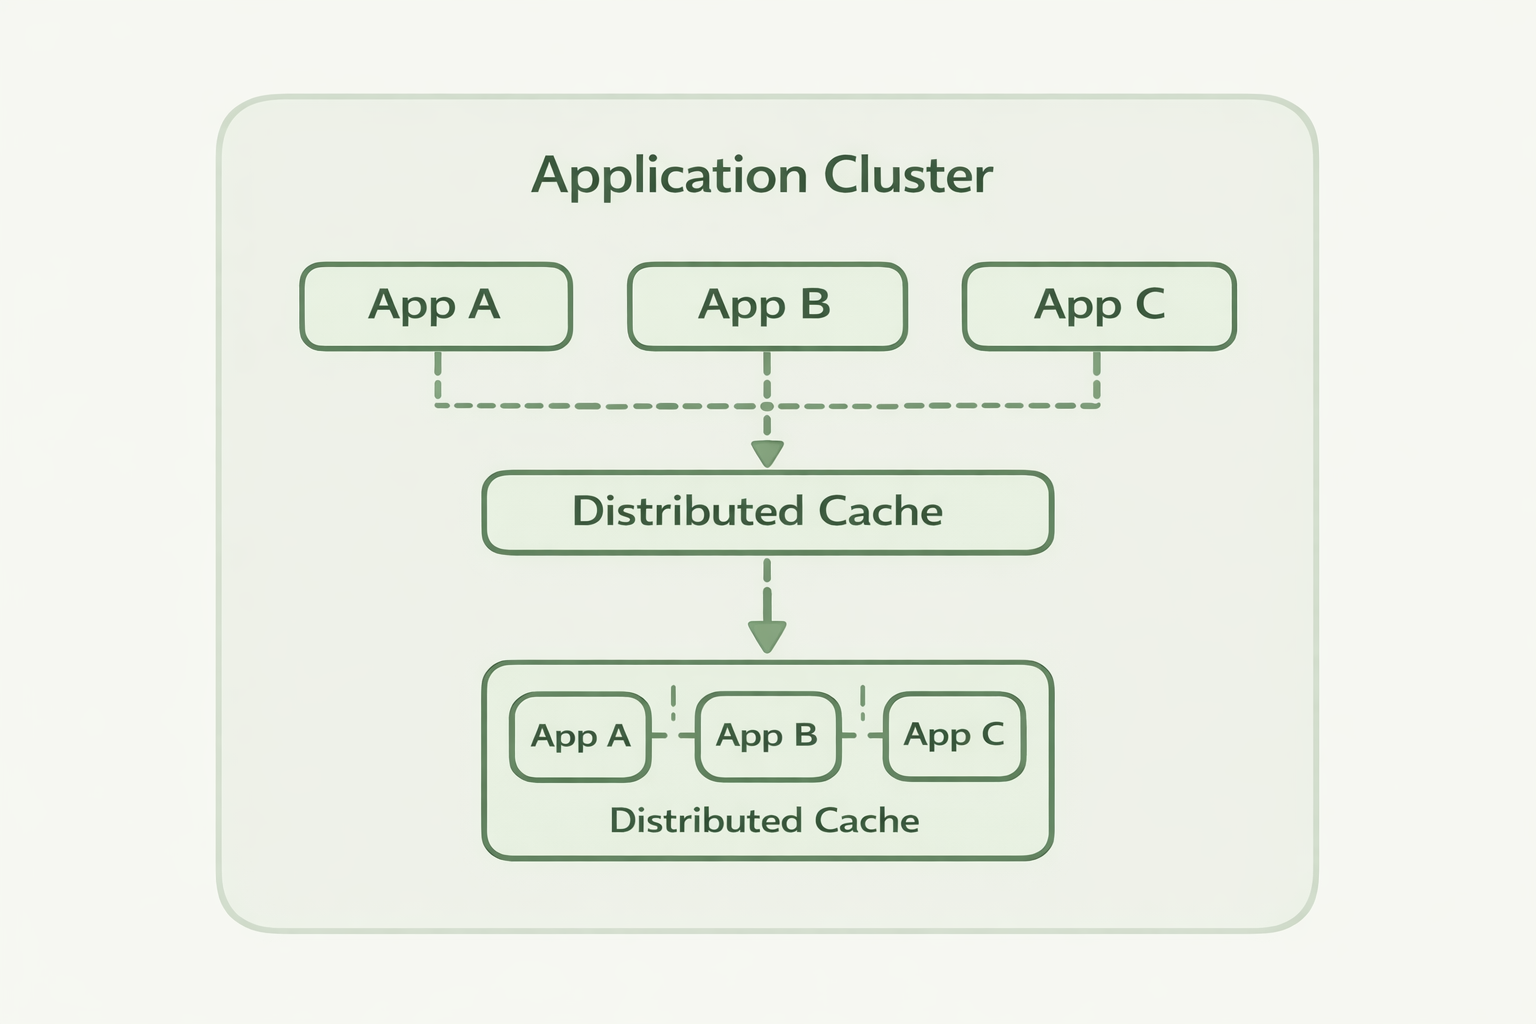
           Application Nodes

        App A     App B     App C
          |         |         |
          +---------+---------+
                    |
            Distributed Cache
Alle Anwendungs-Nodes lesen und schreiben Cache-Einträge im selben verteilten Store.
Das gewährleistet:
- konsistente zwischengespeicherte Daten
- gemeinsam genutzten Anwendungszustand
- bessere Skalierbarkeit
Einfaches Beispiel für einen verteilten Cache in .NET
Ein verteilter Cache wird typischerweise über eine Abstraktion wie
IDistributedCache verwendet.
Beispiel:
public class ProductService
{
    private readonly IDistributedCache _cache;

    public ProductService(IDistributedCache cache)
    {
        _cache = cache;
    }

    public async Task<string?> GetProductAsync(string id)
    {
        var cached = await _cache.GetStringAsync(id);

        if (cached != null)
            return cached;

        var product = await LoadProductFromDatabase(id);

        await _cache.SetStringAsync(id, product);

        return product;
    }

    private Task<string> LoadProductFromDatabase(string id)
    {
        return Task.FromResult($"Product {id}");
    }
}
Die Anwendung prüft zuerst den Cache. Fehlt der Wert, werden die Daten aus der Datenbank geladen und anschließend im Cache abgelegt.
Dieses Muster heißt Cache-Aside-Caching.
Gängige Lösungen für verteilte Caches
Mehrere Technologien bieten verteilte Caching-Funktionen.
Redis
Redis ist einer der am häufigsten eingesetzten verteilten Caches.
Es bietet:
- Key/Value-Speicherung
- hohe Performance
- In-Memory-Operationen
Für die verteilte Koordination benötigt Redis jedoch oft zusätzliche Komponenten.
Datenbankgestützte Caches
Manche Anwendungen nutzen relationale Datenbanken als Cache.
Das ist zwar einfach, bringt aber:
- Datenbank-Contention
- geringere Performance
- eingeschränkte Skalierbarkeit
Verteilte Key/Value-Plattformen
Moderne verteilte Systeme nutzen häufig verteilte Key/Value-Plattformen, die sowohl Caching- als auch Koordinationsprimitive bereitstellen.
Diese Systeme unterstützen:
- verteiltes Caching
- verteilte Locks
- Leader-Election
- Änderungsbenachrichtigungen
- Cluster-Koordination
Clustron als verteilten Cache verwenden
Clustron bietet eine verteilte Key/Value-Plattform, die für .NET- Anwendungen entwickelt wurde.
Da sie als verteilter Cluster läuft, greifen alle Anwendungsinstanzen auf denselben gemeinsamen Datenspeicher zu.
Beispiel:
using Clustron.DKV.Client;

var client = await DKVClient.InitializeRemote(
    "teststore",
    new[]
    {
        new DkvServerInfo("localhost", 7861)
    });

await client.PutAsync("product:1", "Laptop");

var value = await client.GetAsync<string>("product:1");

Console.WriteLine(value);
In diesem Beispiel gilt:
- Anwendungs-Nodes verbinden sich mit dem Cluster
- Daten werden im verteilten Store gespeichert
- alle Nodes sehen dieselben Daten
So bleibt der Cache im gesamten Cluster konsistent.
Wann verteiltes Caching sinnvoll ist
Verteiltes Caching ist besonders nützlich in Systemen, die:
- mehrere Anwendungsinstanzen betreiben
- hohe Request-Volumina verarbeiten
- stark auf Datenbank-Lesezugriffe angewiesen sind
- gemeinsamen Anwendungszustand benötigen
Typische Anwendungsfälle sind:
- ASP.NET-Webanwendungen
- Microservice-Architekturen
- Systeme zur Hintergrundverarbeitung
- API-Plattformen
Zusammenfassung
In-Memory-Caching eignet sich gut für Anwendungen auf einem einzelnen Server, doch moderne verteilte Systeme benötigen eine gemeinsame Caching-Schicht.
Verteiltes Caching erlaubt es mehreren Anwendungsinstanzen, dieselben zwischengespeicherten Daten zu nutzen, und verbessert so Skalierbarkeit und Konsistenz.
Plattformen wie Clustron stellen einen verteilten Key/Value-Store bereit, der verteiltes Caching und Koordination in .NET-Anwendungen einfach umsetzbar macht.