Reaktive Systeme mit Clustron Watch bauen
Die meisten verteilten Systeme beginnen nicht kompliziert.
Sie beginnen mit etwas Einfachem — einer Schleife.
Sie schreiben einen kleinen Worker, der nach Arbeit sucht:
while (true)
{
    var job = await client.GetAsync<Job>("jobs:next");

    if (job.IsSuccess)
    {
        await ProcessAsync(job.Value);
    }

    await Task.Delay(1000);
}
In dieser Phase fühlt sich alles vernünftig an. Die Logik ist klar, das System verhält sich vorhersehbar, und der kognitive Aufwand ist gering.
Doch wenn das System wächst, wird dieses Muster unbemerkt zu einem der teuersten Teile Ihrer Architektur.
Die versteckten Kosten des Pollings in verteilten Systemen
Polling bringt eine grundlegende Ineffizienz mit sich: Sie fragen das System wiederholt nach Änderungen, die in der Regel gar nicht eingetreten sind.
Mit zunehmender Skalierung gilt:
- Mehrere Instanzen beginnen, dieselben Daten abzufragen
- Jede Instanz führt wiederholt Lesezugriffe aus, von denen die meisten keine nützliche Information liefern
- Sie führen künstliche Latenz ein — Änderungen werden erst im nächsten Polling-Zyklus erkannt
- Das System verbraucht Ressourcen allein dafür, zu bestätigen, dass sich nichts geändert hat
Das Ergebnis ist ein System, das technisch korrekt, aber betrieblich ineffizient ist.
Noch wichtiger: Polling zwingt Sie zu Kompromissen, die Sie nicht eingehen sollten:
- Häufig pollen → höhere Kosten, geringere Latenz
- Seltener pollen → geringere Kosten, höhere Latenz
Es gibt keine richtige Antwort — nur Kompromisse.
Ein anderes Modell: Reagieren statt Nachfragen
Die Alternative ist nicht bloß eine Optimierung — sie ist eine andere Denkweise über Systeme.
Statt zu fragen:
„Hat sich etwas geändert?“
entwerfen Sie Ihr System so, dass es auf die Aussage reagiert:
„Gerade hat sich etwas geändert.“
Das ist der Wechsel von einem Pull-basierten Modell zu einem Push-basierten Modell.
In Clustron wird dies über Watch umgesetzt.
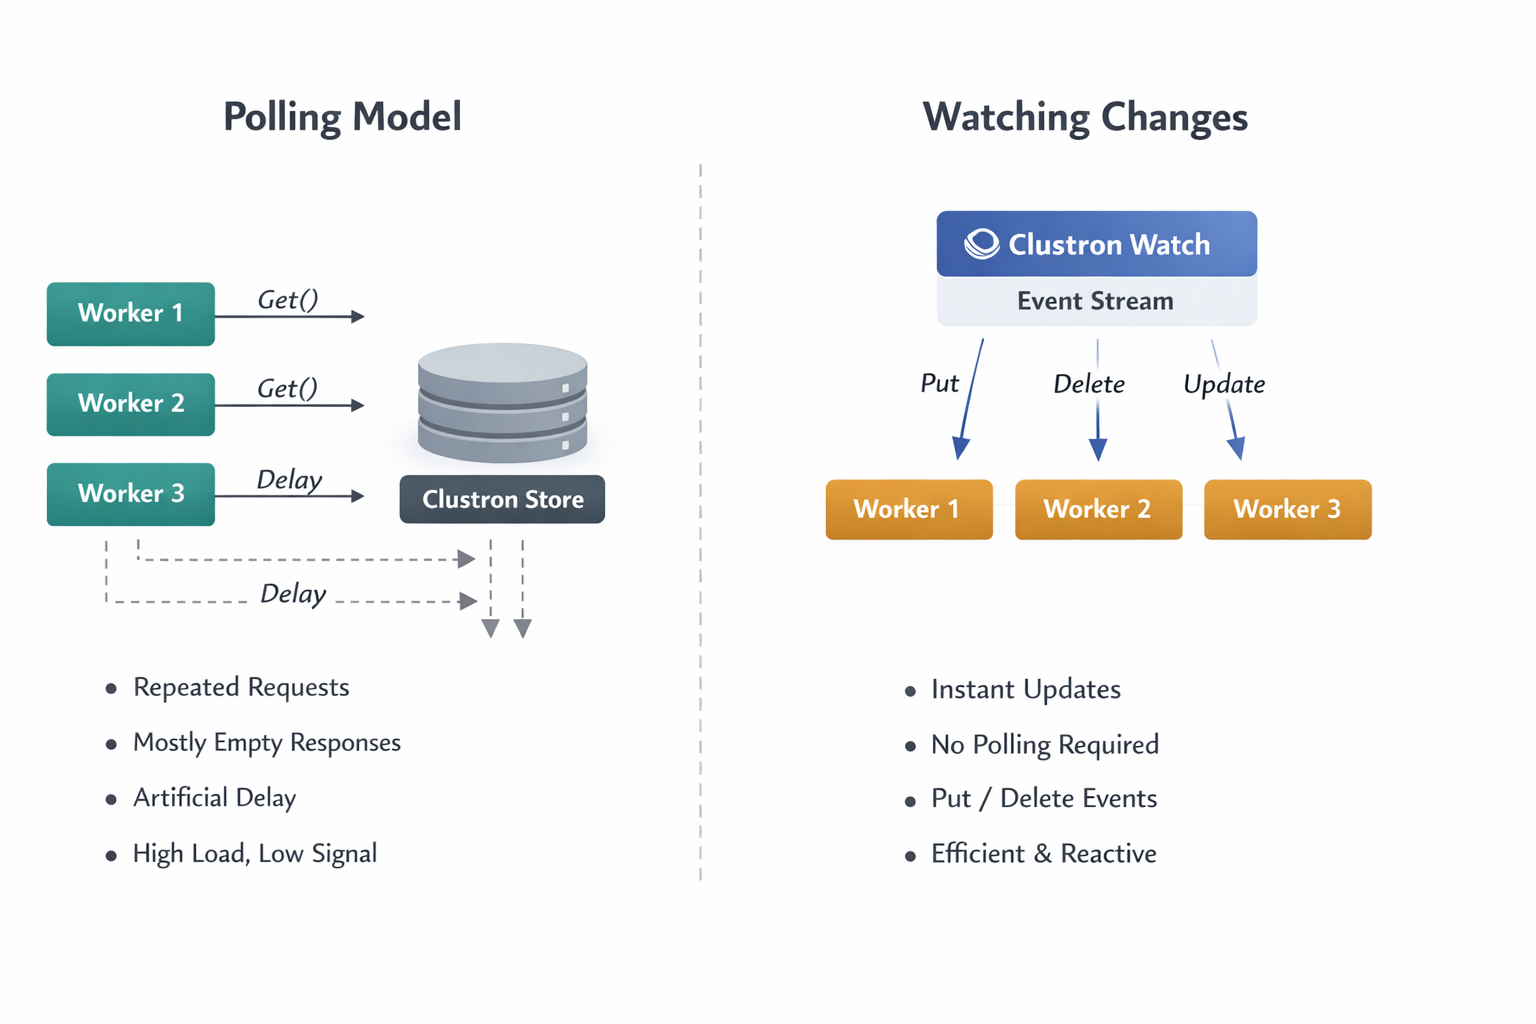
Watch im Überblick: Ein Strom von Zustandsänderungen
Mit Clustron Watch abonnieren Sie Änderungen im System und erhalten Ereignisse, sobald sie eintreten.
Im Kern macht Watch aus Ihren Daten einen kontinuierlichen Strom von Aktualisierungen.
Einen einzelnen Key beobachten
var (subscription, initialRecord) = await client.Watch.WatchKeyAsync(
    "order:1001",
    new WatchOptions { IncludeInitialSnapshot = true },
    ev =>
    {
        Console.WriteLine($"{ev.EventType} → {ev.Key} = {ev.Value}");
    });
Das leistet zwei wichtige Dinge:
- Sie erhalten den aktuellen Zustand (
initialRecord) - Sie abonnieren alle zukünftigen Änderungen
Diese Kombination ist entscheidend. Ohne sie müssten Sie den aktuellen Wert manuell abrufen und anschließend abonnieren — was Race Conditions mit sich bringt.
Snapshot + Streaming: Eine Korrektheitsgarantie
Einer der subtilen, aber wesentlichen Aspekte von Watch ist die Möglichkeit, einen initialen Snapshot einzubeziehen.
Ist IncludeInitialSnapshot aktiviert:
- erhalten Sie den aktuellen Wert zum Zeitpunkt des Abonnements
- erhalten Sie anschließend alle weiteren Aktualisierungen in der richtigen Reihenfolge
Damit ist sichergestellt, dass:
- Sie keinen bestehenden Zustand verpassen
- Sie keine zukünftigen Änderungen verpassen
- Sie keine zusätzliche Synchronisationslogik benötigen
Mit anderen Worten: Watch liefert eine vollständige und konsistente Sicht auf die Entwicklung des Zustands.
Collections beobachten: Über einzelne Keys hinaus
Einen einzelnen Key zu beobachten ist nützlich, doch die meisten realen Systeme arbeiten mit Gruppen zusammengehöriger Daten.
Clustron unterstützt dies durch präfixbasiertes Beobachten:
var subscription = await client.Watch.WatchPrefixAsync(
    "jobs:",
    new WatchOptions { IncludeInitialSnapshot = false },
    ev =>
    {
        Console.WriteLine($"Job update: {ev.Key}");
    });
So können Sie alle Änderungen innerhalb einer logischen Gruppe beobachten.
Aus architektonischer Sicht wird Watch hier deutlich leistungsfähiger:
- Sie reagieren nicht mehr auf einzelne Werte
- Sie reagieren auf systemweite Zustandsübergänge
Das Ereignismodell verstehen
Jede Änderung im System erzeugt ein WatchEvent.
Ein typisches Ereignis enthält:
- den Key, der sich geändert hat
- die Art der Änderung (
PutoderDelete) - den neuen Wert (sofern zutreffend)
- eine Revision, die die Version der Änderung darstellt
Diese Revision ist besonders wichtig. Sie liefert eine Reihenfolge und erlaubt es Ihnen, die Abfolge von Ereignissen über ein verteiltes System hinweg nachzuvollziehen.
Effektiv liefert Watch Ihnen ein Protokoll von Zustandsübergängen, in Echtzeit zugestellt.
Was das in der Praxis ermöglicht
Sobald Sie dieses Modell übernehmen, werden mehrere häufige Probleme einfacher.
Job-Verarbeitung
Statt nach neuer Arbeit zu pollen, reagieren Worker sofort, wenn Jobs angelegt oder aktualisiert werden.
Das beseitigt Leerlaufzyklen und senkt die Latenz.
Cache-Invalidierung
Statt sich auf TTL oder periodische Aktualisierung zu verlassen, können Caches sich selbst als Reaktion auf tatsächliche Änderungen aktualisieren.
Das verbessert sowohl Aktualität als auch Effizienz.
Verteilte Koordination
Systeme, die auf gemeinsamem Zustand beruhen — etwa Leader-Election oder Lease-Besitz —, profitieren erheblich von Echtzeit-Aktualisierungen.
Änderungen werden sofort weitergegeben, was eine schnellere und zuverlässigere Koordination ermöglicht.
Presence und Monitoring
Aktive Komponenten zu verfolgen wird trivial:
- Erscheint ein Node → erhalten Sie ein Ereignis
- Verschwindet ein Node → erhalten Sie ein Ereignis
Kein Polling, kein Raten.
Betriebliche Aspekte
Watch ist für langlaufende, ereignisgesteuerte Workloads konzipiert.
Einige wichtige Hinweise:
Handler schlank halten
Ihr Event-Handler sollte keine aufwendige Arbeit direkt ausführen.
Stattdessen:
- schnell verarbeiten
- aufwendigere Aufgaben an Hintergrund-Worker delegieren
Lebenszyklus von Subscriptions verwalten
Beenden Sie Subscriptions stets, wenn sie nicht mehr benötigt werden:
await subscription.StopAsync();
So werden Ressourcen sauber freigegeben.
Den Geltungsbereich verstehen
- Einen Key beobachten → nur dieser Key erzeugt Ereignisse
- Ein Präfix beobachten → nur passende Keys erzeugen Ereignisse
Ereignisse sind eingegrenzt und isoliert, was unbeabsichtigtes Übersprechen zwischen Komponenten verhindert.
Von Polling-Schleifen zu reaktiven Systemen
Der Wechsel vom Polling zum Beobachten betrifft nicht nur die Performance.
Er verändert die Struktur Ihrer Anwendung.
Polling-Systeme sind aufgebaut um:
Loop → Check → Wait → Repeat
Reaktive Systeme sind aufgebaut um:
Event → Handler → Action
Das Ergebnis sind Systeme, die:
- reaktionsschneller sind
- effizienter sind
- leichter nachvollziehbar sind
Schlussgedanken
Polling ist oft der einfachste Einstieg und funktioniert in kleinen Systemen gut genug.
Doch wenn Systeme wachsen, lassen sich die Kosten des Pollings immer schwerer rechtfertigen.
Clustron Watch bietet einen anderen Ansatz — einen, bei dem Ihr System auf Änderungen reagiert, statt nach ihnen zu suchen.
Stop asking your system if something changed.

Let it tell you when it does.
(Fragen Sie Ihr System nicht länger, ob sich etwas geändert hat. Lassen Sie es Ihnen sagen, wenn es so weit ist.)
Erste Schritte
Probieren Sie ein einfaches Watch aus:
await client.Watch.WatchPrefixAsync("orders:", null, ev =>
{
    Console.WriteLine($"{ev.Key} updated");
});
Beginnen Sie von dort aus, Polling-Schleifen zu entfernen — eine nach der anderen.
Sie werden schnell feststellen, dass Ihr System nicht nur schneller, sondern grundlegend einfacher wird.