Construire des systèmes réactifs avec Clustron Watch
La plupart des systèmes distribués ne commencent pas de façon compliquée.
Ils débutent avec quelque chose de simple — une boucle.
Vous écrivez un petit worker qui recherche du travail :
while (true)
{
    var job = await client.GetAsync<Job>("jobs:next");

    if (job.IsSuccess)
    {
        await ProcessAsync(job.Value);
    }

    await Task.Delay(1000);
}
À ce stade, tout semble raisonnable. La logique est claire, le système se comporte de façon prévisible et la charge cognitive est très faible.
Mais à mesure que le système grandit, ce modèle devient discrètement l'une des parties les plus coûteuses de votre architecture.
Le coût caché du polling dans les systèmes distribués
Le polling introduit une inefficacité fondamentale : vous interrogez sans cesse le système à propos de changements qui, la plupart du temps, ne se sont pas produits.
À mesure que vous montez en charge :
- Plusieurs instances commencent à interroger les mêmes données
- Chaque instance effectue des lectures répétées, dont la plupart ne renvoient aucune information utile
- Vous introduisez une latence artificielle — les changements ne sont détectés qu'au cycle de polling suivant
- Le système se met à consommer des ressources simplement pour confirmer que rien n'a changé
Cela aboutit à un système techniquement correct, mais inefficace sur le plan opérationnel.
Plus important encore, le polling vous oblige à faire des arbitrages que vous ne devriez pas avoir à faire :
- Interroger fréquemment → coût plus élevé, latence plus faible
- Interroger moins fréquemment → coût plus faible, latence plus élevée
Il n'y a pas de bonne réponse — seulement un compromis.
Un modèle différent : réagir plutôt que demander
L'alternative n'est pas qu'une simple optimisation — c'est une autre façon de penser les systèmes.
Au lieu de demander :
« Quelque chose a-t-il changé ? »
Vous concevez votre système pour qu'il réagisse à :
« Quelque chose vient de changer. »
C'est le passage d'un modèle pull à un modèle push.
Dans Clustron, cela s'implémente au moyen de Watch.
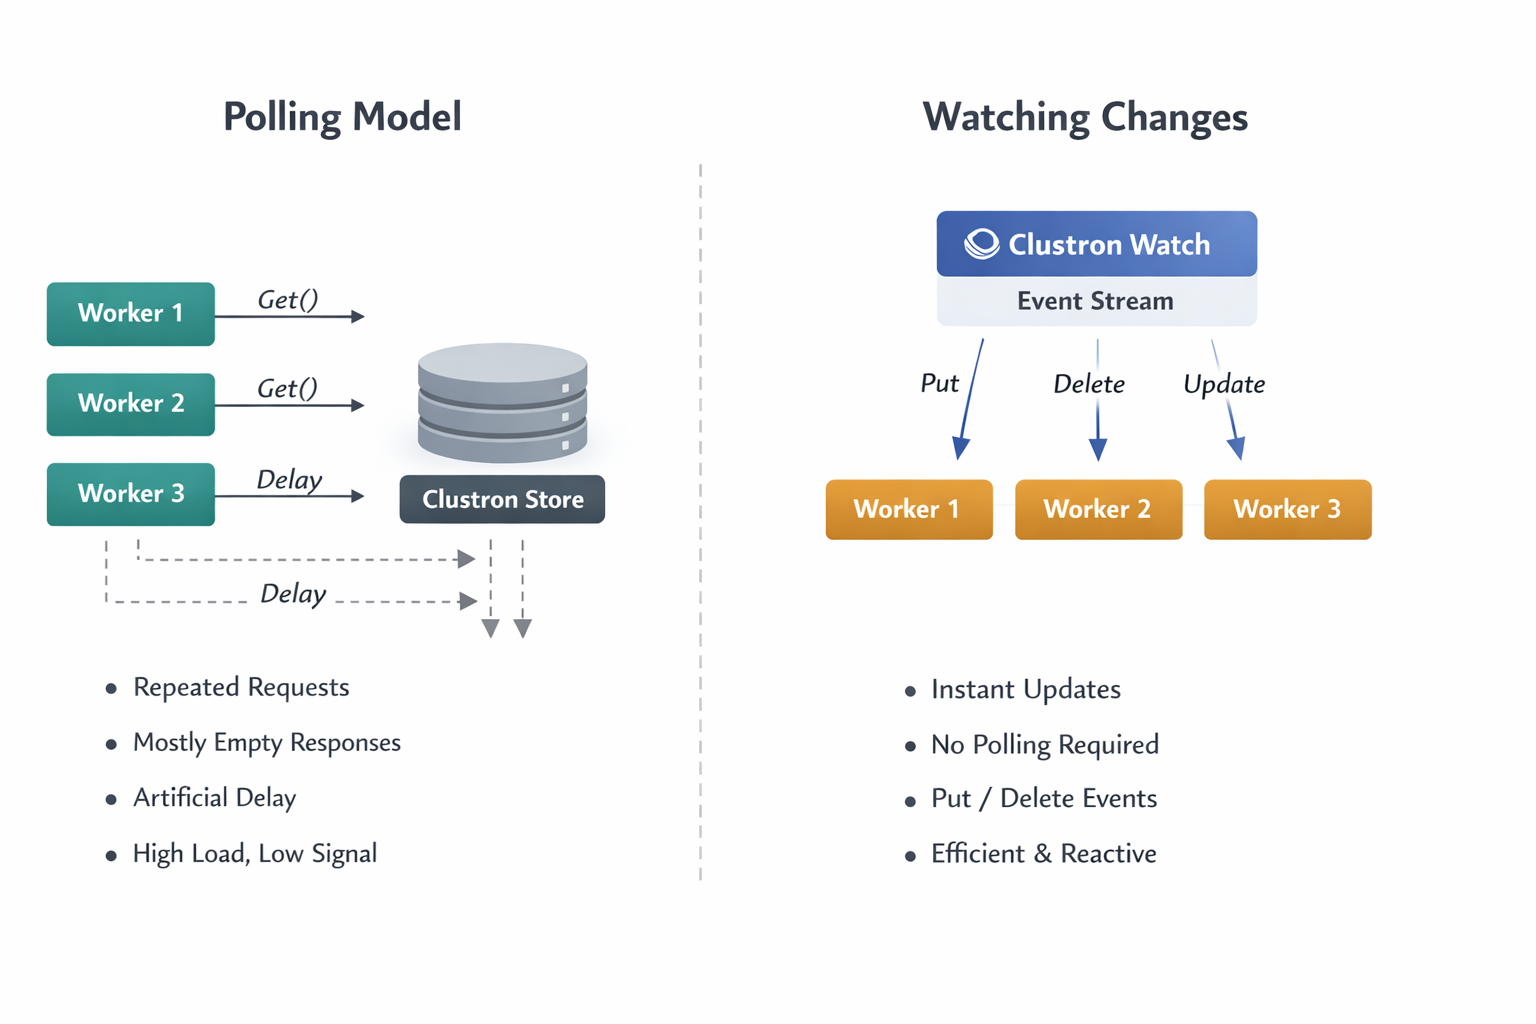
Présentation de Watch : un flux de changements d'état
Clustron Watch vous permet de vous abonner aux changements du système et de recevoir les événements au fur et à mesure qu'ils surviennent.
Fondamentalement, Watch transforme vos données en un flux continu de mises à jour.
Observer une clé unique
var (subscription, initialRecord) = await client.Watch.WatchKeyAsync(
    "order:1001",
    new WatchOptions { IncludeInitialSnapshot = true },
    ev =>
    {
        Console.WriteLine($"{ev.EventType} → {ev.Key} = {ev.Value}");
    });
Cela fait deux choses importantes :
- Cela vous donne l'état courant (
initialRecord) - Cela vous abonne à tous les changements futurs
Cette combinaison est essentielle. Sans elle, vous devriez récupérer manuellement la valeur courante puis vous abonner — ce qui introduit des conditions de concurrence.
Snapshot + streaming : une garantie de correction
L'un des aspects subtils mais essentiels de Watch est la possibilité d'inclure un snapshot initial.
Lorsque IncludeInitialSnapshot est activé :
- Vous recevez la valeur courante au moment de l'abonnement
- Vous recevez ensuite toutes les mises à jour ultérieures dans l'ordre
Cela garantit que :
- Vous ne manquez pas l'état existant
- Vous ne manquez pas les changements futurs
- Vous n'avez pas besoin de logique de synchronisation supplémentaire
Autrement dit, Watch fournit une vue complète et cohérente de l'évolution de l'état.
Observer des collections : au-delà des clés uniques
Observer une clé unique est utile, mais la plupart des systèmes réels opèrent sur des groupes de données liées.
Clustron prend cela en charge via l'observation par préfixe :
var subscription = await client.Watch.WatchPrefixAsync(
    "jobs:",
    new WatchOptions { IncludeInitialSnapshot = false },
    ev =>
    {
        Console.WriteLine($"Job update: {ev.Key}");
    });
Cela vous permet d'observer tous les changements au sein d'un groupe logique.
D'un point de vue architectural, c'est là que Watch devient nettement plus puissant :
- Vous ne réagissez plus à des valeurs individuelles
- Vous réagissez à des transitions d'état à l'échelle du système
Comprendre le modèle d'événements
Chaque changement dans le système produit un WatchEvent.
Un événement typique contient :
- La clé qui a changé
- Le type de changement (
PutouDelete) - La nouvelle valeur (le cas échéant)
- Une révision représentant la version du changement
Cette révision est particulièrement importante. Elle fournit un ordre et vous permet de raisonner sur la séquence des événements à travers un système distribué.
En pratique, Watch vous donne un journal des transitions d'état, livré en temps réel.
Ce que cela permet en pratique
Une fois ce modèle adopté, plusieurs problèmes courants deviennent plus simples.
Traitement des tâches
Au lieu d'interroger pour trouver du nouveau travail, les workers réagissent immédiatement lorsque des tâches sont créées ou mises à jour.
Cela supprime les cycles d'inactivité et réduit la latence.
Invalidation du cache
Plutôt que de s'appuyer sur un TTL ou un rafraîchissement périodique, les caches peuvent se mettre à jour en réponse aux changements réels.
Cela améliore à la fois la fraîcheur et l'efficacité.
Coordination distribuée
Les systèmes qui s'appuient sur un état partagé — comme l'élection de leader ou la possession d'un bail — tirent un bénéfice considérable des mises à jour en temps réel.
Les changements se propagent instantanément, permettant une coordination plus rapide et plus fiable.
Présence et supervision
Suivre les composants actifs devient trivial :
- Lorsqu'un nœud apparaît → vous recevez un événement
- Lorsqu'un nœud disparaît → vous recevez un événement
Pas de polling, pas de devinettes.
Considérations opérationnelles
Watch est conçu pour les charges de travail durables et pilotées par les événements.
Quelques points importants à considérer :
Gardez les handlers légers
Votre handler d'événements ne devrait pas effectuer directement de travail lourd.
Au lieu de cela :
- Traitez rapidement
- Déléguez les tâches plus lourdes à des workers d'arrière-plan
Gérez le cycle de vie des abonnements
Arrêtez toujours les abonnements lorsqu'ils ne sont plus nécessaires :
await subscription.StopAsync();
Cela garantit que les ressources sont libérées proprement.
Comprenez la portée
- Observer une clé → seule cette clé produit des événements
- Observer un préfixe → seules les clés correspondantes produisent des événements
Les événements sont cadrés et isolés, ce qui évite les interférences non intentionnelles entre composants.
Des boucles de polling aux systèmes réactifs
Le passage du polling à l'observation ne concerne pas seulement les performances.
Il change la structure de votre application.
Les systèmes de polling sont construits autour de :
Loop → Check → Wait → Repeat
Les systèmes réactifs sont construits autour de :
Event → Handler → Action
Il en résulte des systèmes qui sont :
- Plus réactifs
- Plus efficaces
- Plus faciles à appréhender
En conclusion
Le polling est souvent le moyen le plus simple de démarrer, et dans les petits systèmes, il fonctionne suffisamment bien.
Mais à mesure que les systèmes grandissent, le coût du polling devient de plus en plus difficile à justifier.
Clustron Watch propose une approche différente — une approche où votre système réagit au changement au lieu de le rechercher.
Stop asking your system if something changed.

Let it tell you when it does.
Pour commencer
Essayez une observation simple :
await client.Watch.WatchPrefixAsync("orders:", null, ev =>
{
    Console.WriteLine($"{ev.Key} updated");
});
À partir de là, commencez à supprimer les boucles de polling — une par une.
Vous constaterez vite que votre système devient non seulement plus rapide, mais fondamentalement plus simple.