Zum Hauptinhalt springen

Leader-Election in verteilten Systemen

· 4 Minuten Lesezeit

Wenn Anwendungen über mehrere Rechner skalieren, wird die Koordination zu einem der schwierigsten Probleme.
Verteilte Systeme betreiben oft mehrere identische Nodes, die alle dieselbe Arbeit verrichten können. Ohne Koordination versuchen diese Nodes möglicherweise gleichzeitig dieselbe Aufgabe auszuführen, was zu doppelter Arbeit, Race Conditions oder inkonsistentem Zustand führt.

Eine der gängigsten Methoden, dieses Problem zu lösen, ist die Leader-Election.

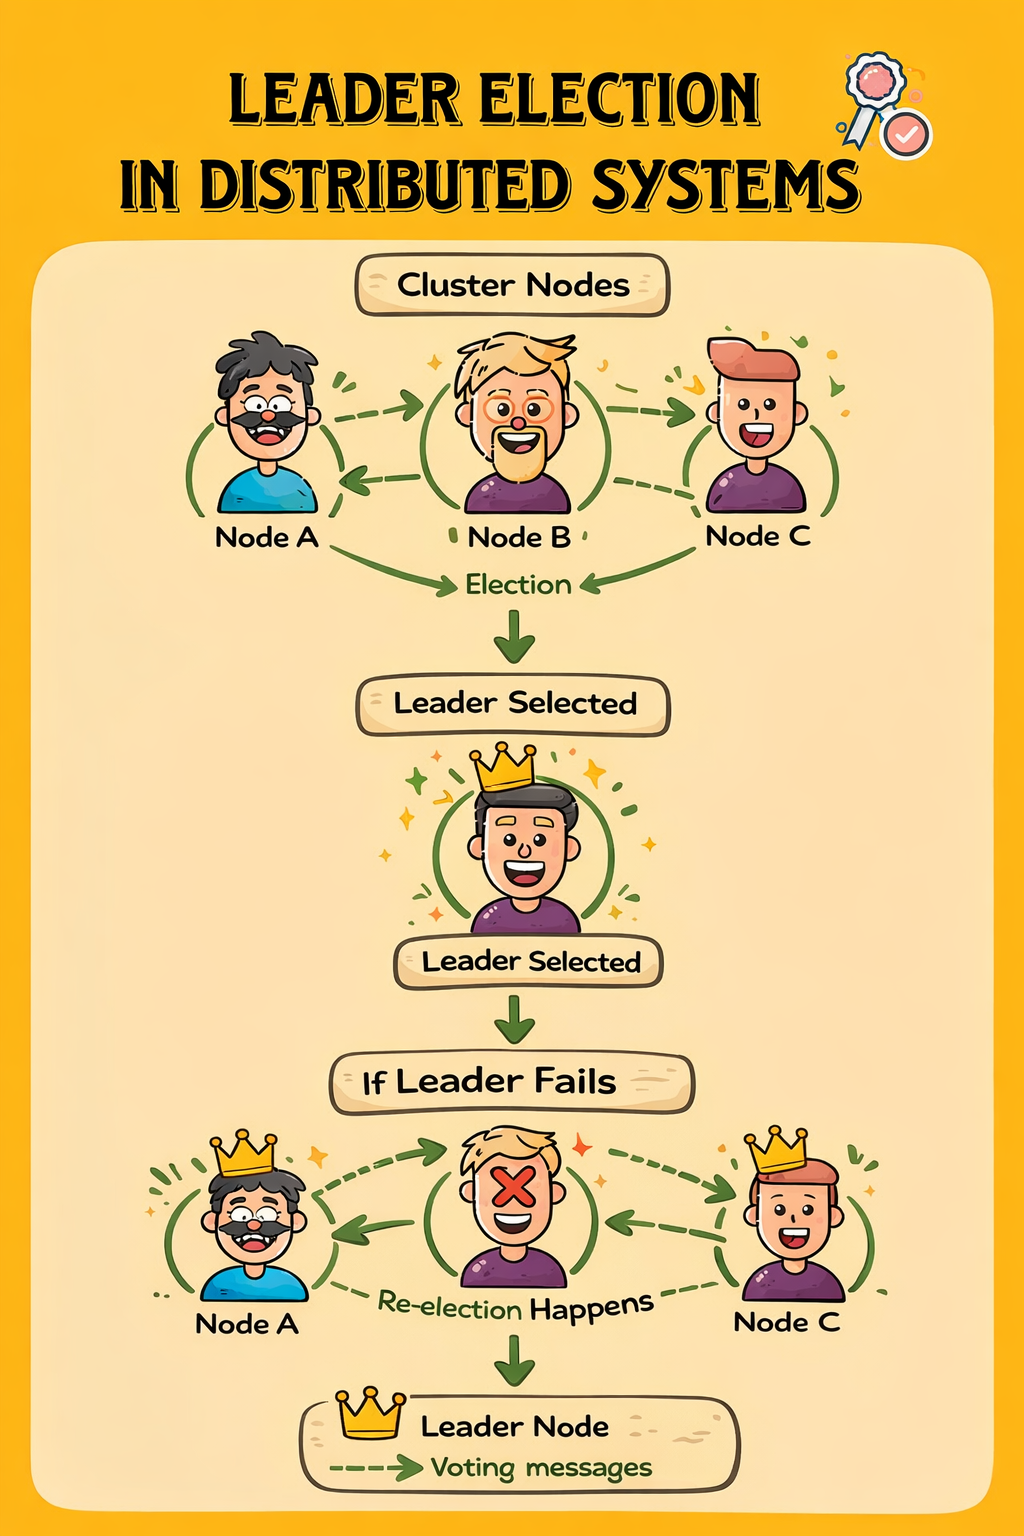
Die Leader-Election stellt sicher, dass ein Node vorübergehend zum Leader wird, während die übrigen Nodes Follower bleiben. Der Leader übernimmt Koordinationsaufgaben, während die Follower auf einen Wechsel der Führung warten.

Dieses Muster wird breit eingesetzt in verteilten Datenbanken, Job-Schedulern, Container-Orchestrierungsplattformen und Konfigurationssystemen.

Leader-Election in verteilten Systemen


Ein einfaches Beispiel

Stellen Sie sich ein verteiltes Worker-System mit drei Nodes vor:

Worker A Worker B Worker C

Jeder Worker kann Hintergrundjobs ausführen.

Führen alle Worker denselben geplanten Job aus, läuft er dreimal.
Stattdessen soll genau ein Worker den Job ausführen.

Hier kommt die Leader-Election ins Spiel. Ein Worker wird zum Leader, und nur der Leader führt den Job aus.


Das einfachste Leader-Election-Muster

Ein gängiger Ansatz nutzt einen gemeinsamen Koordinations-Store.

Die Idee ist einfach:

  1. Jeder Node versucht, die Führung zu übernehmen.
  2. Der Node, dem das gelingt, wird zum Leader.
  3. Der Leader erneuert seine Führung regelmäßig.
  4. Fällt der Leader aus, übernimmt ein anderer Node.

Typischerweise wird dies mit einem Lease umgesetzt.

Ein Lease funktioniert wie ein Lock mit Ablaufzeit. Verschwindet der Node, der den Lease hält, kann ein anderer Node die Führung gefahrlos übernehmen.


Ein minimales .NET-Beispiel

Das folgende vereinfachte Beispiel zeigt die Idee hinter Lease-basierter Führung.

public class LeaderElection
{
private readonly ILeaseStore _store;
private readonly string _nodeId;

public LeaderElection(ILeaseStore store, string nodeId)
{
_store = store;
_nodeId = nodeId;
}

public async Task RunAsync()
{
while (true)
{
var acquired = await _store.TryAcquireLeaseAsync("cluster-leader", _nodeId, TimeSpan.FromSeconds(10));

if (acquired)
{
Console.WriteLine($"{_nodeId} is leader");

await PerformLeaderWork();

await _store.RenewLeaseAsync("cluster-leader", _nodeId);
}

await Task.Delay(2000);
}
}

private Task PerformLeaderWork()
{
Console.WriteLine("Running scheduled tasks...");
return Task.CompletedTask;
}
}

In diesem Beispiel gilt:

  • Jeder Node versucht, den Lease "cluster-leader" zu erwerben.
  • Der Node, dem das gelingt, wird zum Leader.
  • Der Leader erneuert den Lease regelmäßig.
  • Stürzt der Leader ab, läuft der Lease ab, und ein anderer Node übernimmt.

Dieses Muster bietet automatisches Failover.


Probleme bei selbstgebauter Leader-Election

Obwohl das obige Beispiel einfach aussieht, bringen reale verteilte Systeme Komplikationen mit sich:

Netzwerkpartitionen können dazu führen, dass Nodes glauben, noch Leader zu sein.

Clock Drift kann Probleme beim Ablauf von Leases verursachen.

Eine langsame Fehlererkennung kann den Wechsel der Führung verzögern.

Einen robusten Leader-Election-Mechanismus zu bauen, erfordert den sorgfältigen Umgang mit den Randfällen verteilter Systeme.

Deshalb setzen viele Systeme auf spezialisierte Koordinationsplattformen wie:

  • etcd
  • ZooKeeper
  • Consul

Diese Systeme implementieren zuverlässige Koordinationsprimitive.


Leader-Election mit Clustron

Clustron bietet eine Clustering-Plattform für verteilte Systeme in .NET.

Statt Koordinationsinfrastruktur selbst zu bauen, können Anwendungen die integrierten Primitive der Plattform nutzen.

Beispiel mit dem Lease-Konzept von Clustron:

using Clustron.DKV.Client;

var client = await DKVClient.InitializeRemote(
"teststore",
new[] { new DkvServerInfo("localhost", 7861) });

var lease = await client.GrantLeaseAsync(TimeSpan.FromSeconds(10));

if (lease.Acquired)
{
Console.WriteLine("This node is the leader.");

while (true)
{
await client.RefreshLeaseAsync(lease.Id);
await Task.Delay(3000);
}
}

Hier fordert der Node einen Lease vom Cluster an.

Wird der Lease gewährt, wird der Node zum Leader.
Solange der Node den Lease aktualisiert, bleibt die Führung gültig.

Stürzt der Node ab oder erneuert er den Lease nicht mehr, kann ein anderer Node die Führung automatisch übernehmen.


Wann Leader-Election nützlich ist

Leader-Election tritt in vielen realen verteilten Systemen auf:

  • Verteilte Job-Scheduler
  • Verarbeitung von Hintergrundaufgaben
  • Cluster-Manager
  • Koordination von Microservices
  • Konfigurations-Controller

Immer wenn ein System genau einen Node zur Koordination der Aktivitäten benötigt, wird die Leader-Election unverzichtbar.


Zusammenfassung

Die Leader-Election ist ein grundlegender Baustein verteilter Systeme.

Sie ermöglicht es Node-Clustern, ihr Verhalten zu koordinieren und dabei Hochverfügbarkeit zu wahren.

Ein Lease-basierter Ansatz bietet eine einfache und wirksame Implementierungsstrategie, und verteilte Plattformen wie Clustron stellen diese Primitive direkt für .NET-Anwendungen bereit.

Statt Koordinationslogik von Grund auf zu bauen, können sich Entwickler auf das Anwendungsverhalten konzentrieren, während die Clustering-Plattform Führung, Failover und Koordination übernimmt.
Verteilte Locks erklärt

· 4 Minuten Lesezeit
Clustron Team
Engineering für verteilte Systeme

Ein praktischer Leitfaden für .NET-Entwickler

Einleitung​

Wenn Anwendungen über mehrere Rechner skalieren, wird die Koordination zu einem der schwierigsten Aspekte des Systementwurfs.

In einer Anwendung auf einem einzelnen Rechner ist gegenseitiger Ausschluss unkompliziert. Entwickler können sich auf Sprachprimitive wie lock in C#, Mutex oder Semaphore verlassen, um sicherzustellen, dass jeweils nur ein Thread auf eine gemeinsame Ressource zugreift.

Diese Primitive funktionieren jedoch nur innerhalb eines einzelnen Prozesses oder Rechners.

Sobald Anwendungen über mehrere Dienste oder Nodes laufen, greifen klassische Locking-Mechanismen nicht mehr. Zwei Dienste auf verschiedenen Rechnern können sich nicht auf eine lokale lock-Anweisung stützen, um den Zugriff auf gemeinsamen Zustand zu koordinieren.

Hier werden verteilte Locks unverzichtbar.

Verteilte Locks erlauben es Diensten in einem Cluster, den Zugriff auf gemeinsame Ressourcen zu koordinieren und dabei sicherzustellen, dass zu einem gegebenen Zeitpunkt nur ein Teilnehmer den Lock hält.


Lokale Locks vs. verteilte Locks​

Ein typischer lokaler Lock in C# sieht so aus:

private static readonly object _lock = new object();

public void ProcessOrder()
{
lock(_lock)
{
Console.WriteLine("Processing order safely.");
}
}

Das funktioniert einwandfrei innerhalb eines einzelnen Prozesses.

Läuft Ihre Anwendung jedoch auf mehreren Dienstinstanzen, besitzt jede Instanz ihr eigenes _lock-Objekt. Der Lock koordiniert die Arbeit nicht mehr über das gesamte System.

Worker A → lock acquired Worker B → lock acquired Worker C → lock acquired

Alle Worker fahren gleichzeitig fort, womit der Zweck des Lockings verfehlt ist.

Verteilte Systeme benötigen einen gemeinsamen Koordinationsmechanismus.


Verteiltes Locking


Die Idee hinter verteilten Locks​

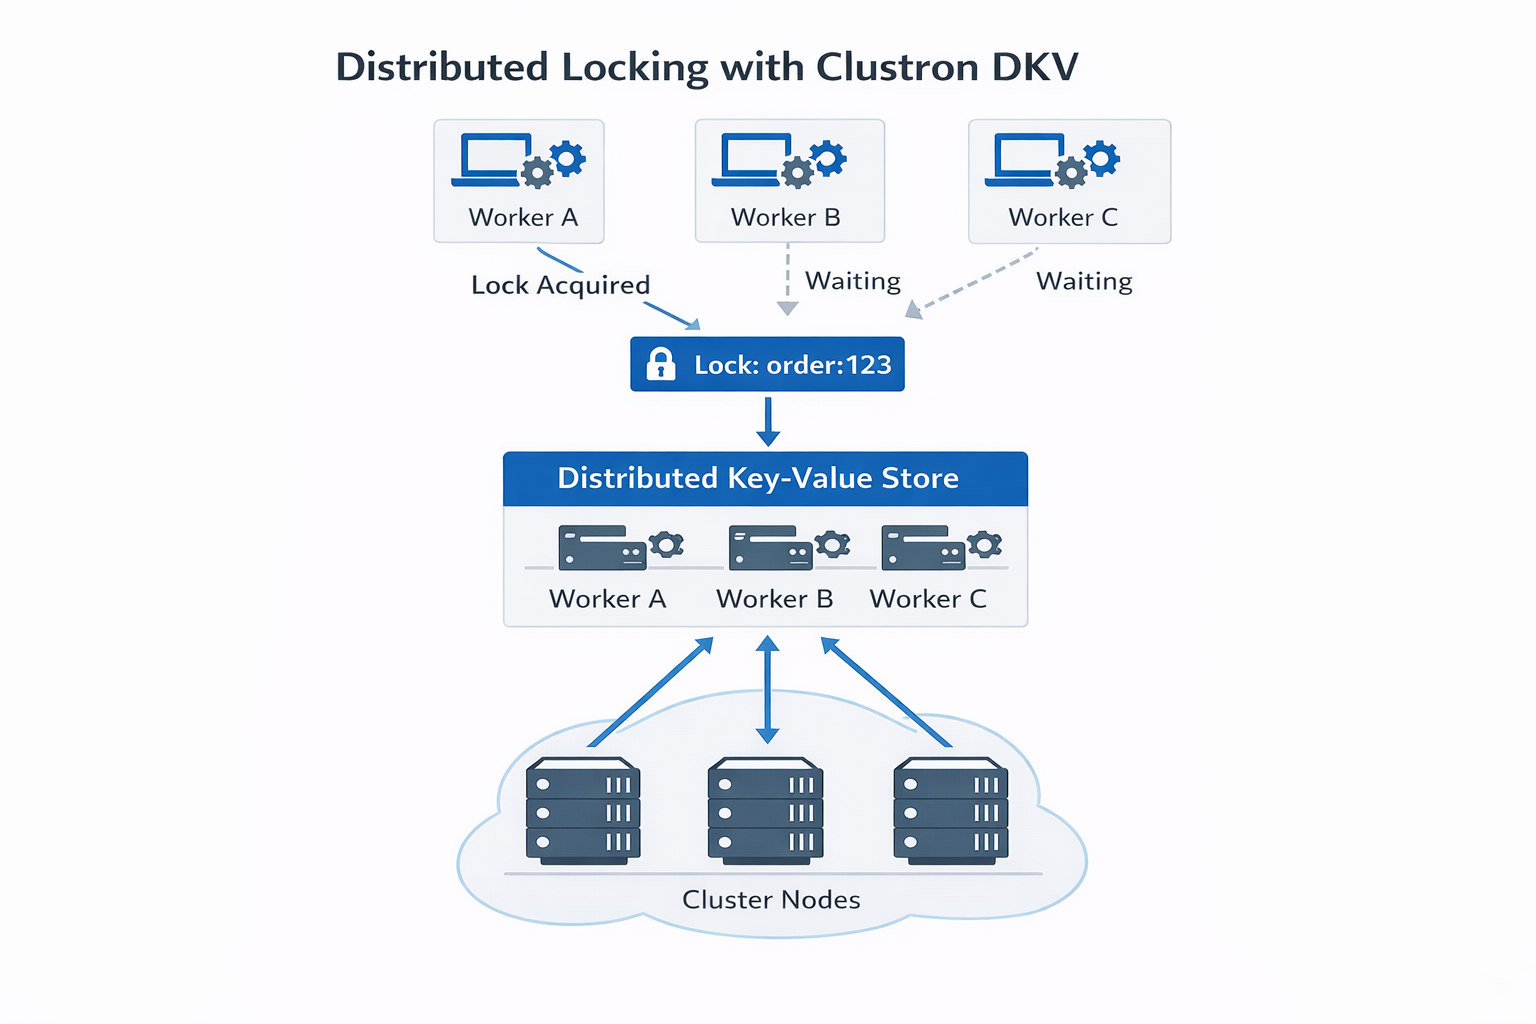
Ein verteilter Lock nutzt ein gemeinsames System, um den Besitz des Locks abzubilden.

Statt Speicher zu sperren, hält ein Node den Lock-Besitz in einem verteilten Koordinationssystem fest, zum Beispiel in:

  • einem verteilten Key/Value-Store
  • einem Koordinationsdienst
  • einem verteilten Cache

Beispielkonzept:

Lock Key: order:123 Owner: worker‑1

Versucht ein anderer Worker, denselben Lock zu erwerben, schlägt die Operation fehl, bis der Lock freigegeben wird oder abläuft.


Praxisszenario: Verteilte Rechnungsverarbeitung​

Stellen Sie sich einen Cluster von Workern vor, die Rechnungen verarbeiten.

Worker A Worker B Worker C

Alle Worker suchen nach offenen Rechnungen.

Ohne Locking:

Worker A → processes invoice #101 Worker B → processes invoice #101 Worker C → processes invoice #101

Dieselbe Rechnung könnte mehrfach verarbeitet werden.

Ein verteilter Lock stellt sicher, dass nur ein Worker die Rechnung verarbeitet.


Verteilte Locks mit Clustron DKV​

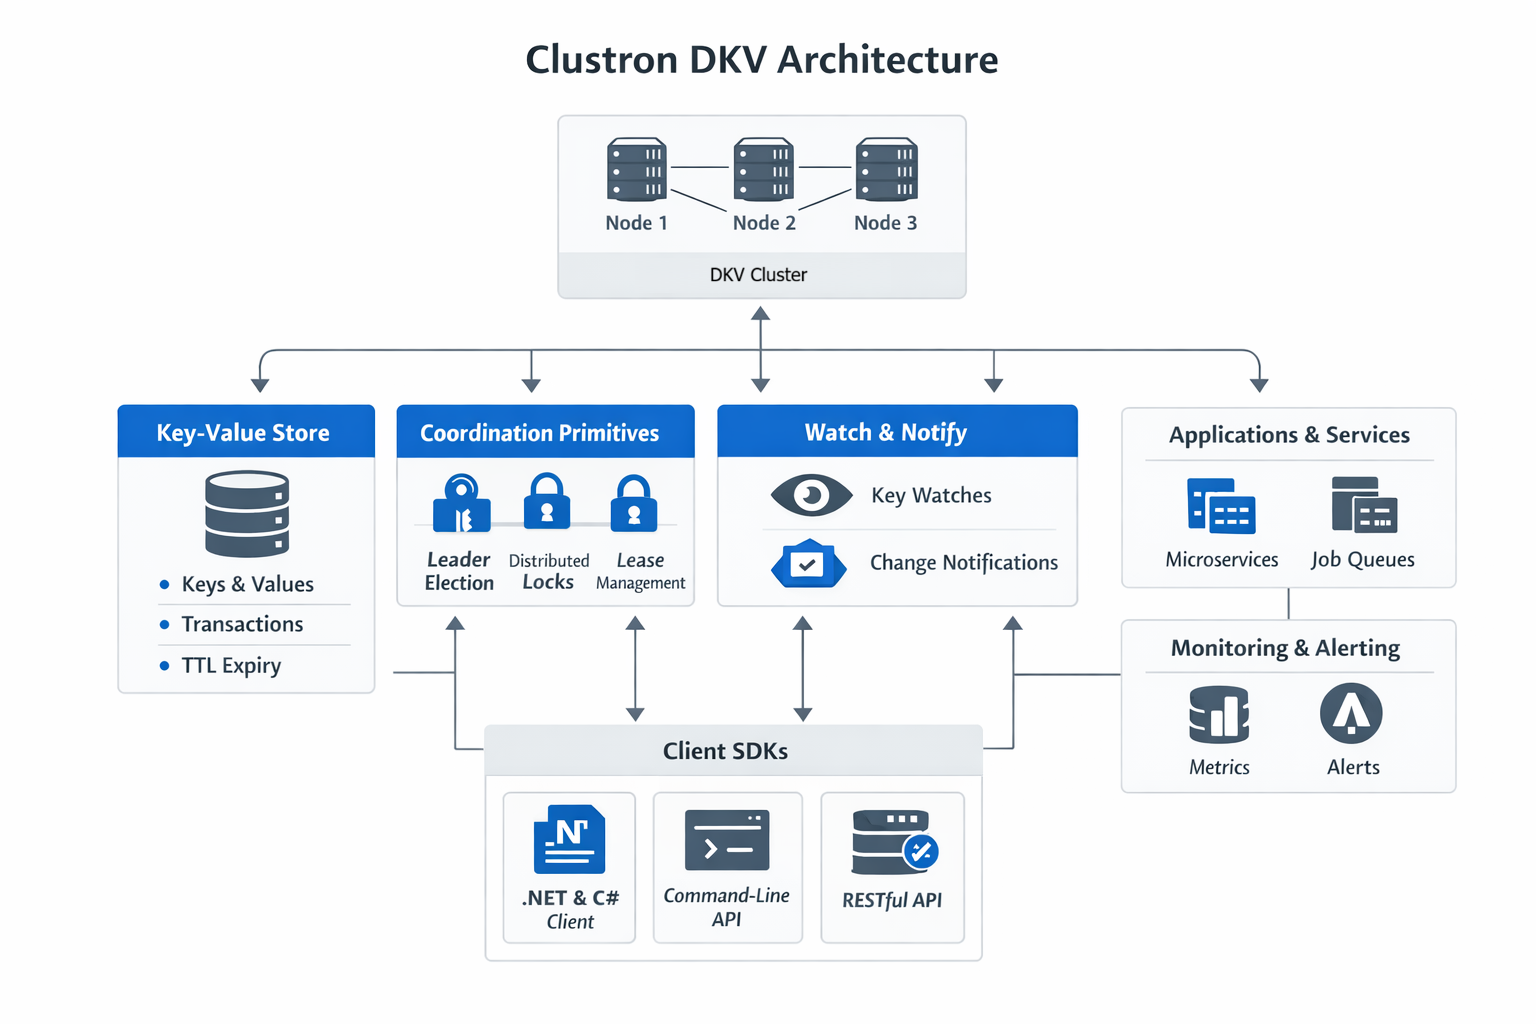
Clustron DKV bietet integrierte Primitive für die verteilte Koordination.

Locks werden über die Locks API verwaltet, und Operationen auf gesperrten Keys müssen das korrekte Lock-Handle enthalten.


Einen Lock erwerben​

Ein Client erwirbt zunächst einen Lock für einen bestimmten Key.

var locks = ((IDkv)client).Locks;

var key = "order:123";

var lockHandle = await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

if (lockHandle == null)
{
Console.WriteLine("Failed to acquire lock.");
return;
}

Console.WriteLine("Lock acquired.");

Das zurückgegebene Lock-Handle repräsentiert den Besitz des Locks.


Operationen unter dem Lock ausführen​

Sobald ein Lock erworben wurde, müssen Operationen das Lock-Handle enthalten.

var result = await client.PutAsync(
key,
"processed",
Put.WithLock(lockHandle.Handle));

if (result.IsSuccess)
{
Console.WriteLine("Value updated safely.");
}

Nur der Lock-Besitzer kann den Wert ändern.


Lesen mit dem Lock​

Auch Lesezugriffe können den Lock-Besitz berücksichtigen.

var value = await client.GetAsync<string>(
key,
Get.WithLock(lockHandle.Handle));

if (value.IsSuccess)
{
Console.WriteLine($"Value: {value.Value}");
}

Konkurrierende Operationen ohne den Lock​

Versucht ein anderer Worker, den Key ohne den Lock zu ändern, schlägt die Operation fehl.

var attempt = await client.PutAsync(key, "new-value");

if (!attempt.IsSuccess)
{
Console.WriteLine($"Operation rejected: {attempt.Status}");
}

Ergebnis:

KvStatus.Locked

Dies verhindert die gleichzeitige Änderung derselben Ressource.


Den Lock freigeben​

Ist die Arbeit abgeschlossen, kann der Lock freigegeben werden.

await lockHandle.ReleaseAsync();

Console.WriteLine("Lock released.");

Nach der Freigabe kann ein anderer Worker den Lock erwerben.


Beispielhafter Cluster-Ablauf​

Worker A → Acquire Lock → Success Worker B → Acquire Lock → Failed Worker C → Acquire Lock → Failed

Worker A → Update Key Worker A → Release Lock

Nur ein Worker führt die Operation aus, was die Korrektheit sicherstellt.


Umgang mit Ausfällen​

Locks in Clustron sind zeitlich begrenzt.

Beim Erwerb eines Locks muss eine Dauer angegeben werden:

await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

Stürzt der Client, der den Lock hält, ab oder bricht die Verbindung ab, läuft der Lock schließlich ab, sodass ein anderer Worker ihn erwerben kann.

Dadurch bleiben Locks nicht dauerhaft gehalten.


Best Practices​

Bei der Implementierung verteilter Locks:

  • Halten Sie kritische Abschnitte kurz
  • Vermeiden Sie nach Möglichkeit globale Locks
  • Partitionieren Sie Locks nach Ressource
  • Planen Sie stets für Fehlerszenarien

Schlussgedanken​

Verteilte Locks gehören zu den grundlegendsten Koordinationsprimitiven in verteilten Systemen.

Sie erlauben es Diensten auf mehreren Rechnern, den Zugriff auf gemeinsame Ressourcen sicher zu koordinieren und dabei die Korrektheit des Systems zu wahren.

Plattformen wie Clustron DKV vereinfachen dies durch integrierte Locking-Primitive, atomare Operationen und starke Konsistenzgarantien.

Im nächsten Artikel betrachten wir ein weiteres essenzielles Primitiv verteilter Systeme:

Leader-Election.

Verteilte Systeme entwickeln

· 4 Minuten Lesezeit
Clustron Team
Engineering für verteilte Systeme

Ein praktischer Leitfaden für .NET-Entwickler

Einleitung​

Die meisten Backend-Systeme beginnen ihr Leben auf einem einzelnen Rechner.

Eine ASP.NET-Core-Anwendung verarbeitet Requests, eine Datenbank speichert die Anwendungsdaten, und Hintergrundprozesse übernehmen asynchrone Aufgaben wie den Versand von E-Mails oder die Erstellung von Berichten. In dieser Umgebung ist Nebenläufigkeit beherrschbar, und die Koordination zwischen den Komponenten ist vergleichsweise einfach.

Wächst das System jedoch, ändert sich das.

Der Traffic nimmt zu, mehr Anwendungsinstanzen werden hinter einem Load Balancer betrieben, und Dienste laufen auf mehreren Rechnern. Aus der einstigen Einzelanwendung wird ein verteiltes System.

An diesem Punkt ändert sich die Natur des Problems grundlegend.

Die Herausforderungen beschränken sich nicht mehr darauf, korrekte Geschäftslogik zu schreiben. Entwickler müssen sich nun mit der Koordination über Rechnergrenzen hinweg, mit Netzwerkausfällen, Teilausfällen und der Wahrung der Konsistenz über verteilten Zustand befassen.

Hier beginnt die Ingenieurdisziplin der verteilten Systeme.


Architektur verteilter Systeme


Was ist ein verteiltes System?​

Ein verteiltes System ist eine Menge unabhängiger Computer, die dem Benutzer als ein einziges, in sich geschlossenes System erscheinen.

Statt die gesamte Logik auf einem Rechner auszuführen, werden Verantwortlichkeiten auf mehrere Nodes verteilt, die über das Netzwerk kommunizieren.

Beispiele sind:

  • Microservice-Architekturen
  • Verteilte Datenbanken
  • Geclusterte Caches
  • Message Queues
  • Cloud-Infrastrukturplattformen

Diese Systeme bieten Skalierbarkeit und Ausfallsicherheit, bringen aber neue Komplexität mit sich.


Warum verteilte Systeme schwierig sind​

Anders als eine Anwendung auf einem einzelnen Rechner müssen verteilte Systeme mit Gegebenheiten wie den folgenden umgehen:

Netzwerkausfälle​

In verteilten Systemen findet die Kommunikation über ein Netzwerk statt. Netzwerke können langsam, unzuverlässig oder zeitweise nicht verfügbar sein.

Ein Request kann fehlschlagen, weil der entfernte Node abgestürzt ist, weil das Netzwerk Pakete verworfen hat oder weil ein Timeout aufgetreten ist.

Das System muss solche Szenarien kontrolliert abfangen.


Teilausfälle​

In einem verteilten System können Komponenten unabhängig voneinander ausfallen.

Ein Node in einem Cluster kann abstürzen, während die anderen gesund bleiben. Eine Dienstinstanz kann neu starten, während andere Dienste weiterlaufen.

Das bedeutet, dass das System auch dann korrekt arbeiten muss, wenn nur ein Teil davon funktioniert.


Herausforderungen bei der Konsistenz​

Werden Daten über mehrere Nodes hinweg repliziert, wird es schwierig, sie konsistent zu halten.

Zum Beispiel:

  • Zwei Nodes können versuchen, dieselben Daten gleichzeitig zu aktualisieren.
  • Netzwerkverzögerungen können dazu führen, dass sich Nodes vorübergehend nicht über den aktuellen Zustand einig sind.
  • Ein Node kann abstürzen, nachdem er nur einen Teil einer Operation ausgeführt hat.

Systeme, die trotz dieser Szenarien einen konsistenten Zustand wahren, erfordern eine sorgfältige Koordination.


Zentrale Bausteine verteilter Systeme​

Die meisten verteilten Systeme stützen sich auf einige wenige Kernprimitive.

Wer diese Primitive versteht, kann zuverlässige Architekturen besser entwerfen.


Verteilter Speicher​

Daten müssen häufig auf mehrere Rechner verteilt gespeichert werden.

Das ermöglicht:

  • horizontale Skalierung
  • Fehlertoleranz
  • Hochverfügbarkeit

Hierfür werden üblicherweise verteilte Key/Value-Stores eingesetzt.


Koordination​

Nodes müssen Aktionen wie die folgenden koordinieren:

  • Leader-Election
  • verteiltes Locking
  • Cluster-Mitgliedschaft
  • Konfigurationsänderungen

Ohne Koordinationsmechanismen könnten mehrere Nodes widersprüchliche Operationen ausführen.


Konsens​

Manche Systeme benötigen starke Garantien für den gemeinsamen Zustand.

Konsensalgorithmen wie Raft oder Paxos ermöglichen es Nodes, sich auch bei Ausfällen auf Entscheidungen zu einigen.

Diese Algorithmen sind grundlegend für verteilte Datenbanken und Koordinationsdienste.


Partitionierung und Replikation​

Daten werden typischerweise:

  • über Nodes hinweg partitioniert, um die Last zu verteilen
  • repliziert, um sich gegen Ausfälle abzusichern

Performance, Verfügbarkeit und Konsistenz auszubalancieren, ist eine der zentralen Entwurfsherausforderungen.


Gängige Muster verteilter Systeme​

Mehrere Muster tauchen in realen Systemen immer wieder auf.

Beispiele:

  • Leader-Election zur Koordination von Cluster-Aktivitäten
  • Verteilte Locks zur Sicherstellung des gegenseitigen Ausschlusses
  • Job-Queues für die asynchrone Verarbeitung
  • Rate Limiter zur Steuerung des Request-Volumens
  • Transaktionsprotokolle für atomare Aktualisierungen über mehrere Nodes

Diese Muster bilden das Fundament vieler großer Plattformen.


Die Rolle von Koordinationssystemen​

Um die Entwicklung verteilter Systeme zu vereinfachen, setzen viele Organisationen auf Koordinationssysteme wie:

  • etcd
  • ZooKeeper
  • Consul

Diese Systeme stellen Primitive bereit wie:

  • Leader-Election
  • verteilte Locks
  • Cluster-Mitgliedschaft
  • Konfigurationsspeicher

Anwendungen können darauf aufbauend Verhalten auf höherer Ebene umsetzen.


Verteilte Systeme im .NET-Ökosystem​

Während verteilte Infrastrukturwerkzeuge oft mit anderen Ökosystemen in Verbindung gebracht werden, laufen .NET-Anwendungen zunehmend in verteilten Umgebungen.

Moderne .NET-Systeme nutzen häufig:

  • Kubernetes
  • verteilte Caches
  • Microservices
  • ereignisgesteuerte Architekturen

Dadurch gewinnen Koordination und die Verwaltung von verteiltem Zustand auch für .NET-Entwickler zunehmend an Bedeutung.


Schlussgedanken​

Verteilte Systeme zu bauen, unterscheidet sich grundlegend vom Bau klassischer Anwendungen auf einem einzelnen Rechner.

Netzwerkkommunikation, Teilausfälle und Datenkonsistenz bringen Komplexität mit sich, die spezialisierte Muster und Infrastruktur erfordert.

Wer die zentralen Bausteine versteht — Speicher, Koordination, Konsens und Replikation —, kann glücklicherweise Systeme entwerfen, die zuverlässig skalieren und auch bei Ausfällen widerstandsfähig bleiben.

In kommenden Artikeln beleuchten wir einige dieser Primitive genauer, darunter Leader-Election, Koordinationsmuster für verteilte Systeme und praktische Implementierungen in .NET.