Aller au contenu principal

L'élection de leader dans les systèmes distribués

· 5 minutes de lecture

Lorsque les applications montent en charge sur plusieurs machines, la coordination devient l'un des problèmes les plus difficiles à résoudre.
Les systèmes distribués exécutent souvent plusieurs nœuds identiques capables tous d'effectuer le même travail. Sans coordination, ces nœuds peuvent tenter la même tâche simultanément, ce qui entraîne du travail en double, des conditions de concurrence ou un état incohérent.

L'un des moyens les plus courants de résoudre ce problème est l'élection de leader.

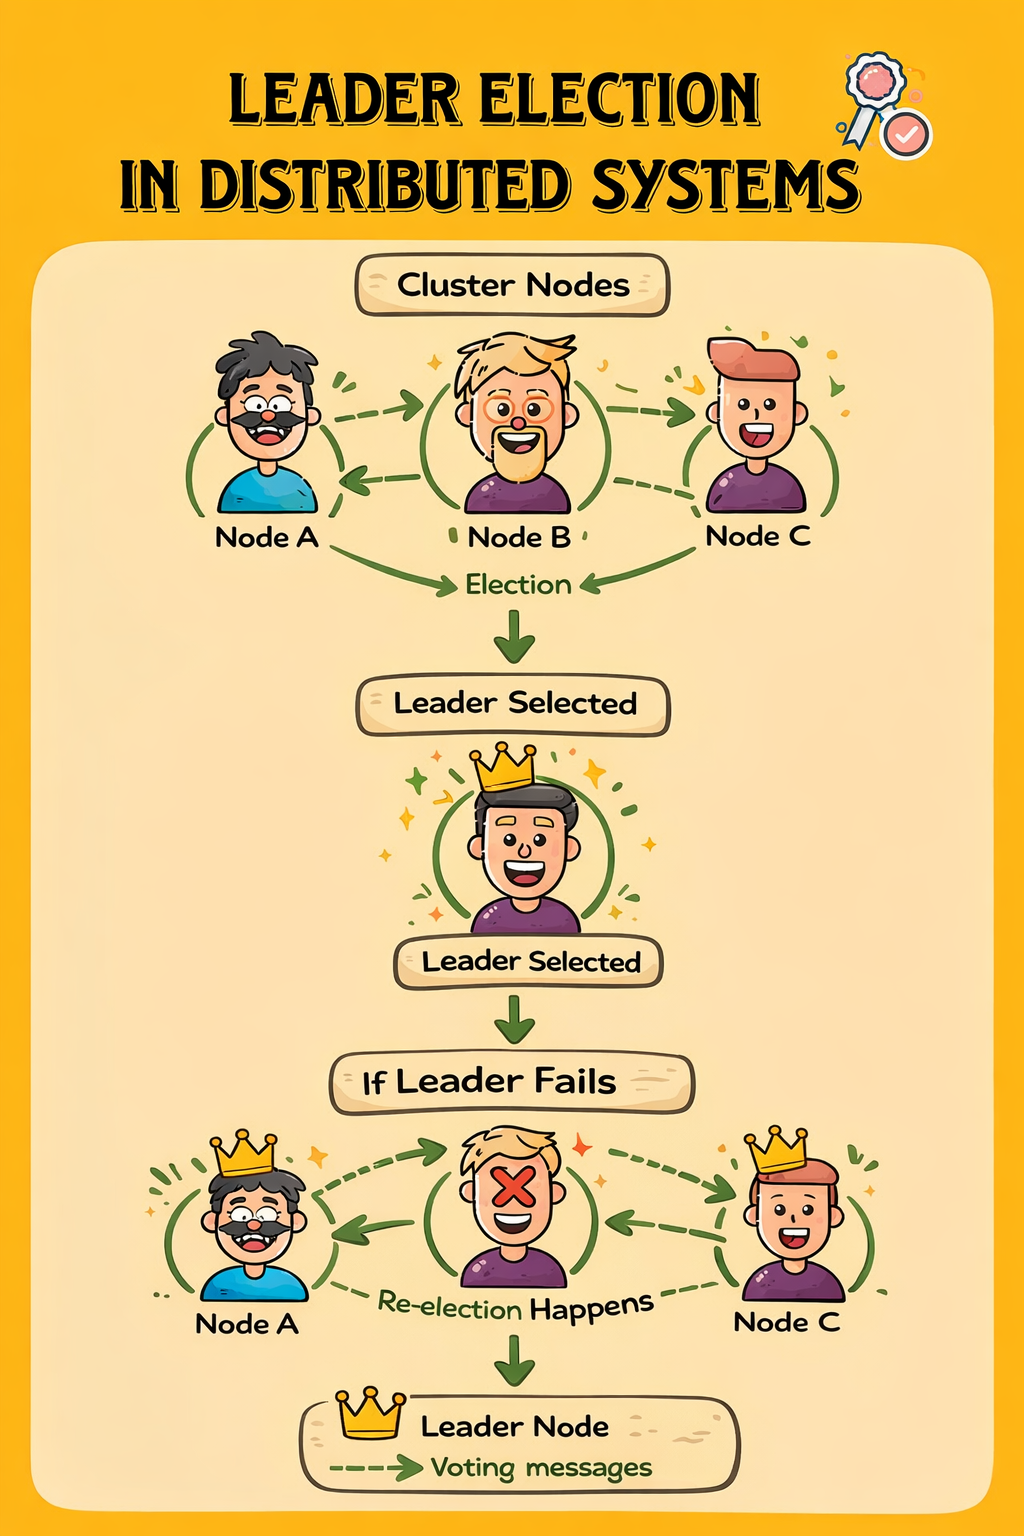
L'élection de leader garantit qu'un nœud devient temporairement le leader tandis que les autres nœuds restent des suiveurs. Le leader effectue les tâches de coordination pendant que les suiveurs attendent un changement de leadership.

Ce modèle est largement utilisé dans les bases de données distribuées, les ordonnanceurs de tâches, les plateformes d'orchestration de conteneurs et les systèmes de configuration.

L'élection de leader dans les systèmes distribués


Un exemple simple

Imaginez un système distribué de workers comportant trois nœuds :

Worker A Worker B Worker C

Chaque worker est capable d'exécuter des tâches d'arrière-plan.

Si tous les workers exécutent la même tâche planifiée, celle-ci s'exécutera trois fois.
À la place, nous voulons qu'exactement un worker exécute la tâche.

C'est là que l'élection de leader devient utile. Un worker devient le leader, et seul le leader exécute la tâche.


Le modèle d'élection de leader le plus simple

Une approche courante utilise un store de coordination partagé.

L'idée est simple :

  1. Chaque nœud tente d'acquérir le leadership.
  2. Le nœud qui réussit devient le leader.
  3. Le leader renouvelle périodiquement son leadership.
  4. Si le leader défaille, un autre nœud prend le relais.

Cela s'implémente généralement à l'aide d'un bail.

Un bail agit comme un verrou assorti d'une durée d'expiration. Si le nœud détenant le bail disparaît, un autre nœud peut acquérir le leadership en toute sécurité.


Un exemple .NET minimal

L'exemple simplifié suivant illustre l'idée sous-jacente au leadership fondé sur les baux.

public class LeaderElection
{
private readonly ILeaseStore _store;
private readonly string _nodeId;

public LeaderElection(ILeaseStore store, string nodeId)
{
_store = store;
_nodeId = nodeId;
}

public async Task RunAsync()
{
while (true)
{
var acquired = await _store.TryAcquireLeaseAsync("cluster-leader", _nodeId, TimeSpan.FromSeconds(10));

if (acquired)
{
Console.WriteLine($"{_nodeId} is leader");

await PerformLeaderWork();

await _store.RenewLeaseAsync("cluster-leader", _nodeId);
}

await Task.Delay(2000);
}
}

private Task PerformLeaderWork()
{
Console.WriteLine("Running scheduled tasks...");
return Task.CompletedTask;
}
}

Dans cet exemple :

  • Chaque nœud tente d'acquérir le bail "cluster-leader".
  • Le nœud qui réussit devient le leader.
  • Le leader renouvelle périodiquement le bail.
  • Si le leader s'arrête brutalement, le bail expire et un autre nœud prend le relais.

Ce modèle assure un basculement automatique.


Les problèmes de l'élection de leader « faite maison »

Bien que l'exemple ci-dessus paraisse simple, les systèmes distribués réels introduisent des complications :

Les partitions réseau peuvent amener des nœuds à croire qu'ils sont toujours leaders.

La dérive d'horloge peut provoquer des problèmes d'expiration de bail.

Une détection de défaillance lente peut retarder le transfert du leadership.

Construire un mécanisme d'élection de leader robuste exige de gérer soigneusement les cas limites des systèmes distribués.

C'est pourquoi de nombreux systèmes s'appuient sur des plateformes de coordination spécialisées telles que :

  • etcd
  • ZooKeeper
  • Consul

Ces systèmes implémentent des primitives de coordination fiables.


L'élection de leader avec Clustron

Clustron fournit une plateforme de clustering pour les systèmes distribués en .NET.

Au lieu de construire vous-même l'infrastructure de coordination, les applications peuvent utiliser les primitives intégrées de la plateforme.

Exemple utilisant le concept de bail de Clustron :

using Clustron.DKV.Client;

var client = await DKVClient.InitializeRemote(
"teststore",
new[] { new DkvServerInfo("localhost", 7861) });

var lease = await client.GrantLeaseAsync(TimeSpan.FromSeconds(10));

if (lease.Acquired)
{
Console.WriteLine("This node is the leader.");

while (true)
{
await client.RefreshLeaseAsync(lease.Id);
await Task.Delay(3000);
}
}

Ici, le nœud demande un bail au cluster.

Si le bail est accordé, le nœud devient le leader.
Tant que le nœud continue de renouveler le bail, le leadership reste valide.

Si le nœud s'arrête brutalement ou cesse de renouveler le bail, un autre nœud peut acquérir le leadership automatiquement.


Quand l'élection de leader est utile

L'élection de leader apparaît dans de nombreux systèmes distribués réels :

  • Les ordonnanceurs de tâches distribués
  • Les processeurs de tâches d'arrière-plan
  • Les gestionnaires de cluster
  • La coordination de microservices
  • Les contrôleurs de configuration

Chaque fois qu'un système requiert qu'exactement un nœud coordonne l'activité, l'élection de leader devient essentielle.


Résumé

L'élection de leader est une brique fondamentale des systèmes distribués.

Elle permet à des clusters de nœuds de coordonner leur comportement tout en maintenant une haute disponibilité.

Une approche fondée sur les baux fournit une stratégie d'implémentation simple et efficace, et des plateformes distribuées telles que Clustron mettent ces primitives directement à la disposition des applications .NET.

Au lieu de construire la logique de coordination de zéro, les développeurs peuvent se concentrer sur le comportement de l'application pendant que la plateforme de clustering gère le leadership, le basculement et la coordination.
Les verrous distribués expliqués

· 5 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Un guide pratique pour les développeurs .NET

Introduction​

À mesure que les applications montent en charge sur plusieurs machines, la coordination devient l'un des aspects les plus délicats de la conception des systèmes.

Dans une application mono-machine, l'exclusion mutuelle est simple. Les développeurs peuvent s'appuyer sur des primitives du langage telles que lock en C#, Mutex ou Semaphore pour garantir qu'un seul thread accède à une ressource partagée à la fois.

Cependant, ces primitives ne fonctionnent qu'au sein d'un seul processus ou d'une seule machine.

Dès lors que les applications s'exécutent sur plusieurs services ou nœuds, les mécanismes de verrouillage traditionnels ne fonctionnent plus. Deux services s'exécutant sur des machines différentes ne peuvent pas s'appuyer sur une instruction lock locale pour coordonner l'accès à un état partagé.

C'est ici que les verrous distribués deviennent essentiels.

Les verrous distribués permettent aux services répartis sur un cluster de coordonner l'accès aux ressources partagées tout en garantissant qu'un seul participant détient le verrou à un instant donné.


Verrous locaux vs verrous distribués​

Un verrou local typique en C# ressemble à ceci :

private static readonly object _lock = new object();

public void ProcessOrder()
{
lock(_lock)
{
Console.WriteLine("Processing order safely.");
}
}

Cela fonctionne parfaitement à l'intérieur d'un seul processus.

Cependant, si votre application s'exécute sur plusieurs instances de service, chaque instance possède son propre objet _lock. Le verrou ne coordonne plus le travail à l'échelle du système.

Worker A → lock acquired Worker B → lock acquired Worker C → lock acquired

Tous les workers progressent simultanément, ce qui annule l'intérêt du verrouillage.

Les systèmes distribués nécessitent un mécanisme de coordination partagé.


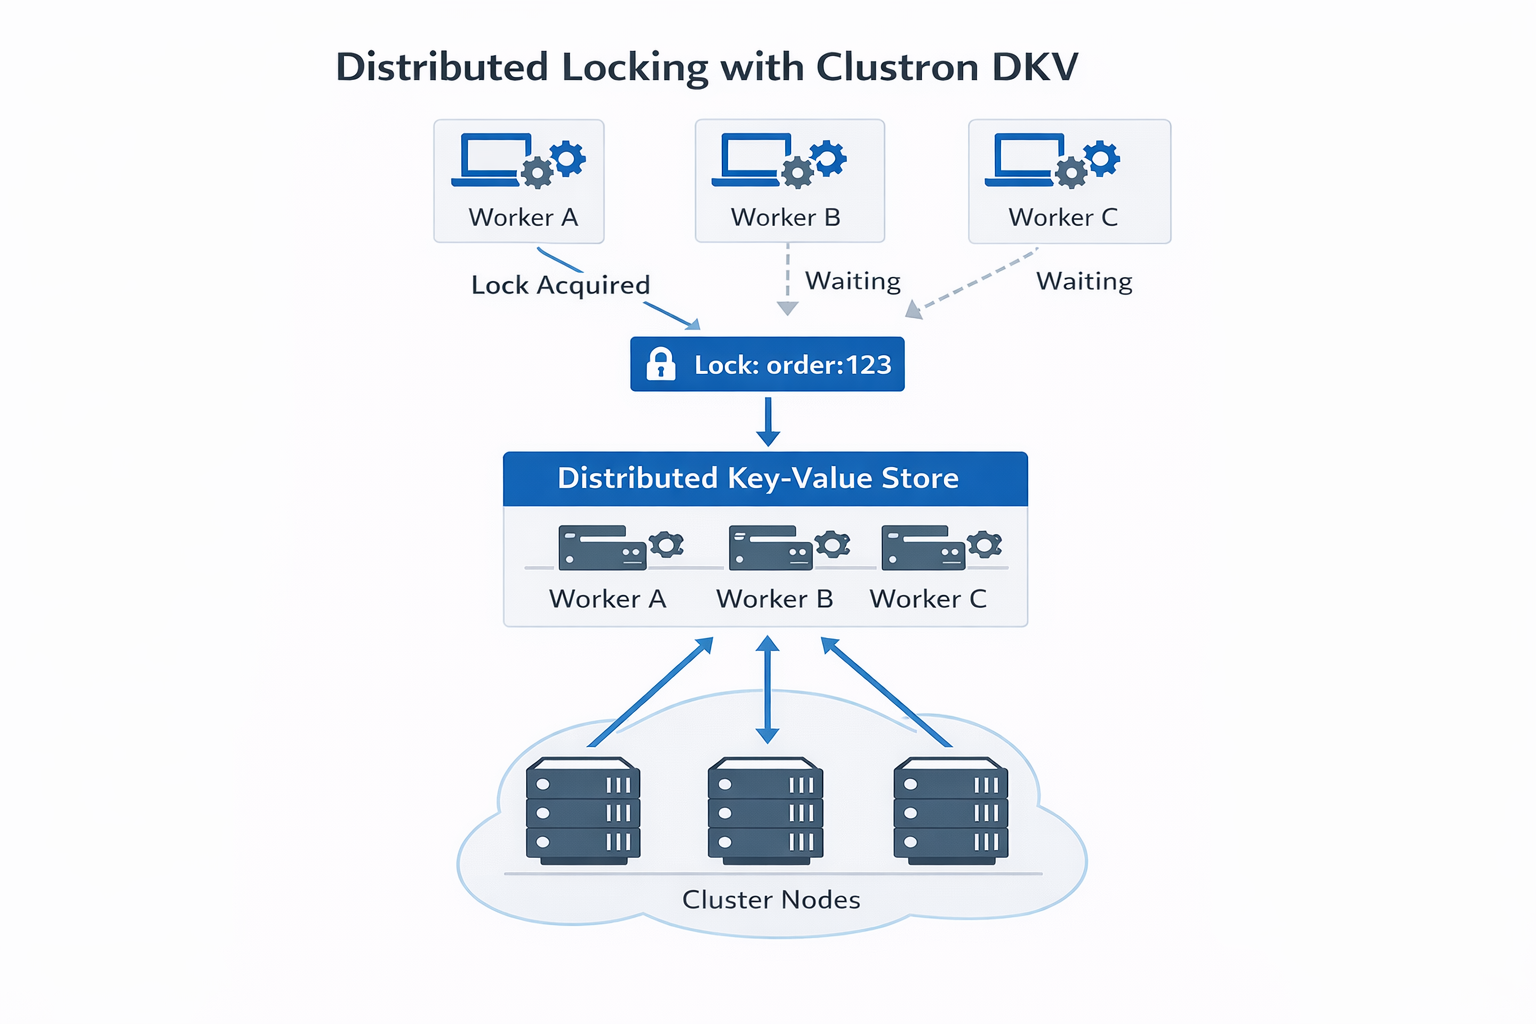
Verrouillage distribué


L'idée derrière les verrous distribués​

Un verrou distribué utilise un système partagé pour représenter la possession du verrou.

Au lieu de verrouiller la mémoire, un nœud enregistre la possession du verrou dans un système de coordination distribué tel que :

  • un store clé-valeur distribué
  • un service de coordination
  • un cache distribué

Concept d'exemple :

Lock Key: order:123 Owner: worker‑1

Si un autre worker tente d'acquérir le même verrou, l'opération échoue jusqu'à ce que le verrou soit libéré ou expire.


Scénario concret : traitement distribué de factures​

Imaginez un cluster de workers traitant des factures.

Worker A Worker B Worker C

Tous les workers recherchent les factures en attente.

Sans verrouillage :

Worker A → processes invoice #101 Worker B → processes invoice #101 Worker C → processes invoice #101

La même facture pourrait être traitée plusieurs fois.

Un verrou distribué garantit qu'un seul worker traite la facture.


Les verrous distribués avec Clustron DKV​

Clustron DKV fournit des primitives intégrées pour la coordination distribuée.

Les verrous sont gérés via l'API Locks, et les opérations sur les clés verrouillées doivent inclure le bon handle de verrou.


Acquérir un verrou​

Un client acquiert d'abord un verrou pour une clé spécifique.

var locks = ((IDkv)client).Locks;

var key = "order:123";

var lockHandle = await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

if (lockHandle == null)
{
Console.WriteLine("Failed to acquire lock.");
return;
}

Console.WriteLine("Lock acquired.");

Le handle de verrou renvoyé représente la possession du verrou.


Effectuer des opérations sous le verrou​

Une fois un verrou acquis, les opérations doivent inclure le handle de verrou.

var result = await client.PutAsync(
key,
"processed",
Put.WithLock(lockHandle.Handle));

if (result.IsSuccess)
{
Console.WriteLine("Value updated safely.");
}

Seul le propriétaire du verrou peut modifier la valeur.


Lire avec le verrou​

Les lectures peuvent elles aussi respecter la possession du verrou.

var value = await client.GetAsync<string>(
key,
Get.WithLock(lockHandle.Handle));

if (value.IsSuccess)
{
Console.WriteLine($"Value: {value.Value}");
}

Opérations concurrentes sans le verrou​

Si un autre worker tente de modifier la clé sans le verrou, l'opération échoue.

var attempt = await client.PutAsync(key, "new-value");

if (!attempt.IsSuccess)
{
Console.WriteLine($"Operation rejected: {attempt.Status}");
}

Résultat :

KvStatus.Locked

Cela empêche la modification concurrente de la même ressource.


Libérer le verrou​

Une fois le travail terminé, le verrou peut être libéré.

await lockHandle.ReleaseAsync();

Console.WriteLine("Lock released.");

Après la libération du verrou, un autre worker peut l'acquérir.


Exemple de workflow de cluster​

Worker A → Acquire Lock → Success Worker B → Acquire Lock → Failed Worker C → Acquire Lock → Failed

Worker A → Update Key Worker A → Release Lock

Un seul worker effectue l'opération, garantissant la correction.


Gérer les défaillances​

Les verrous dans Clustron sont bornés dans le temps.

Lors de l'acquisition d'un verrou, une durée doit être spécifiée :

await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

Si le client détenant le verrou s'arrête brutalement ou se déconnecte, le verrou finit par expirer, ce qui permet à un autre worker de l'acquérir.

Cela évite que les verrous ne restent détenus indéfiniment.


Bonnes pratiques​

Lorsque vous implémentez des verrous distribués :

  • Gardez les sections critiques courtes
  • Évitez les verrous globaux lorsque c'est possible
  • Partitionnez les verrous par ressource
  • Concevez toujours en prévoyant les scénarios de défaillance

En conclusion​

Les verrous distribués sont l'une des primitives de coordination les plus fondamentales des systèmes distribués.

Ils permettent aux services s'exécutant sur plusieurs machines de coordonner en toute sécurité l'accès aux ressources partagées tout en préservant la correction du système.

Des plateformes comme Clustron DKV simplifient cela en fournissant des primitives de verrouillage intégrées, des opérations atomiques et de fortes garanties de cohérence.

Dans le prochain article, nous explorerons une autre primitive essentielle des systèmes distribués :

l'élection de leader.

Concevoir des systèmes distribués

· 5 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Un guide pratique pour les développeurs .NET

Introduction​

La plupart des systèmes backend commencent leur existence sur une seule machine.

Une application ASP.NET Core traite les requêtes, une base de données stocke les données applicatives et des workers d'arrière-plan gèrent les tâches asynchrones telles que l'envoi d'e-mails ou la génération de rapports. Dans cet environnement, la concurrence reste gérable et la coordination entre les composants est relativement simple.

À mesure que le système grandit, cependant, les choses commencent à changer.

Le trafic augmente, davantage d'instances applicatives sont déployées derrière un load balancer et les services s'exécutent sur plusieurs machines. Ce qui était autrefois une application unique évolue vers un système distribué.

À ce stade, la nature du problème change radicalement.

Les défis ne se limitent plus à l'écriture d'une logique métier correcte. Les développeurs doivent désormais composer avec la coordination entre machines, les pannes réseau, les défaillances partielles et le maintien de la cohérence sur un état distribué.

C'est ici que commence l'ingénierie des systèmes distribués.


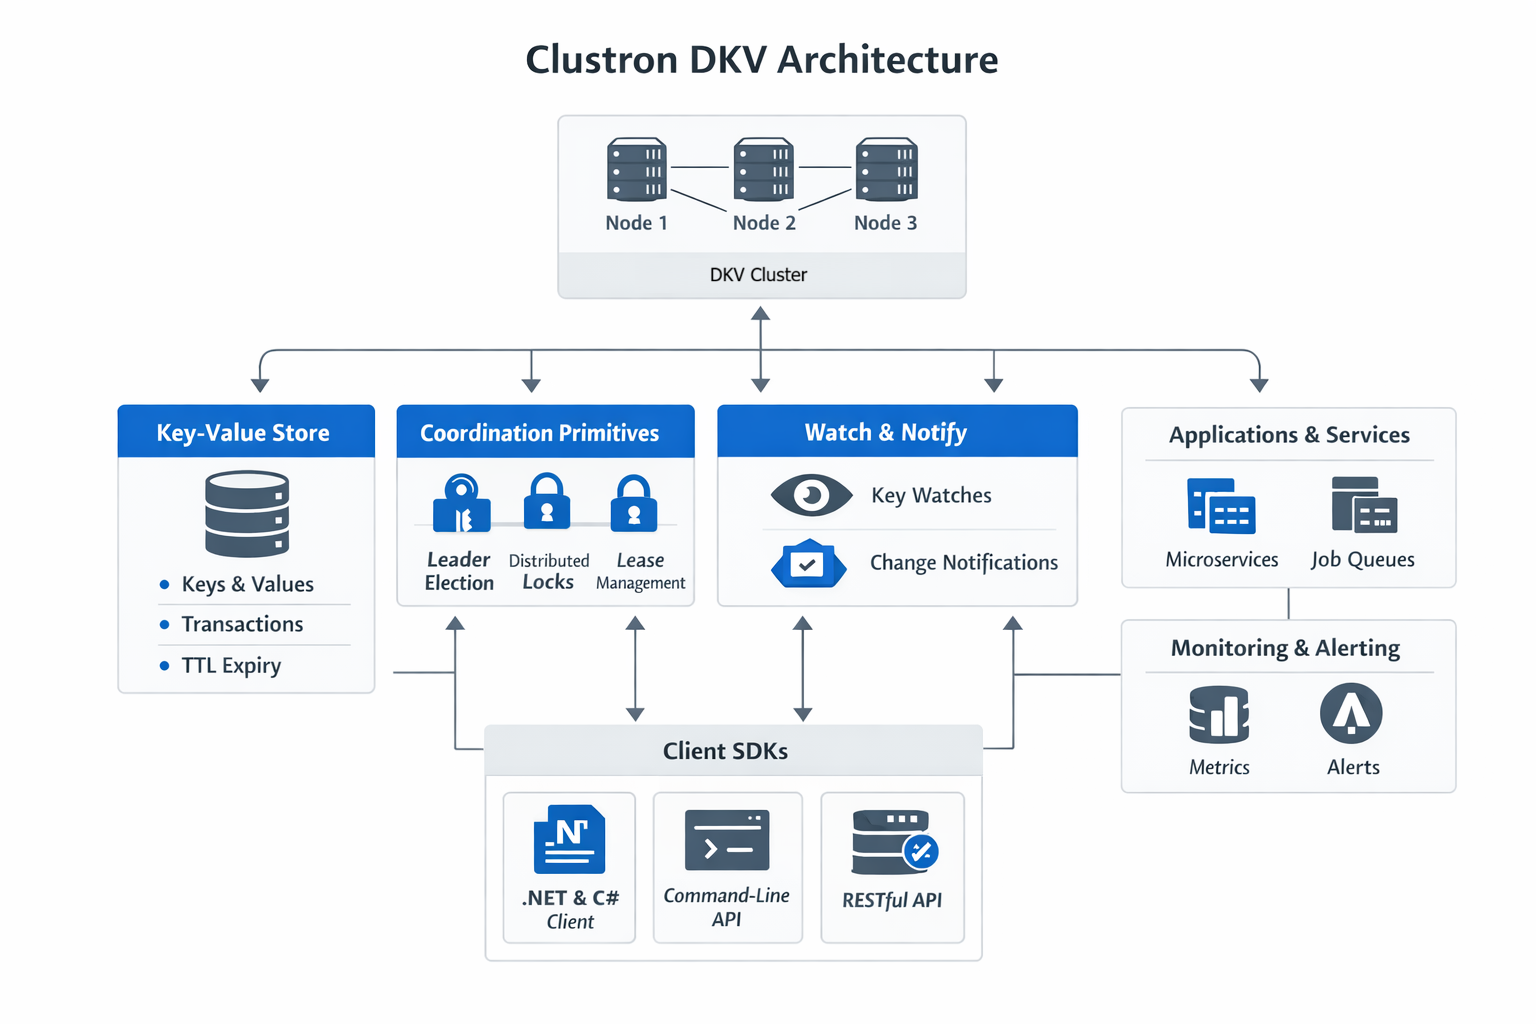
Architecture des systèmes distribués


Qu'est-ce qu'un système distribué ?​

Un système distribué est un ensemble d'ordinateurs indépendants qui apparaissent à l'utilisateur comme un système cohérent unique.

Au lieu d'exécuter toute la logique sur une seule machine, les responsabilités sont réparties sur plusieurs nœuds qui communiquent par le réseau.

En voici quelques exemples :

  • Les architectures microservices
  • Les bases de données distribuées
  • Les caches en cluster
  • Les files de messages
  • Les plateformes d'infrastructure cloud

Ces systèmes offrent évolutivité et résilience, mais introduisent de nouvelles complexités.


Pourquoi les systèmes distribués sont difficiles​

Contrairement à une application mono-machine, les systèmes distribués doivent composer avec des réalités telles que :

Les pannes réseau​

Dans les systèmes distribués, la communication passe par un réseau. Les réseaux peuvent être lents, peu fiables ou temporairement indisponibles.

Une requête peut échouer parce que le nœud distant s'est arrêté brutalement, parce que le réseau a perdu des paquets ou parce qu'un timeout s'est produit.

Le système doit gérer ces scénarios avec élégance.


Les défaillances partielles​

Dans un système distribué, les composants peuvent tomber en panne indépendamment les uns des autres.

Un nœud d'un cluster peut s'arrêter brutalement tandis que les autres restent sains. Une instance de service peut redémarrer pendant que d'autres services continuent de fonctionner.

Cela signifie que le système doit fonctionner correctement même lorsqu'une partie seulement de celui-ci est opérationnelle.


Les défis de cohérence​

Lorsque des données sont répliquées sur plusieurs nœuds, les maintenir cohérentes devient difficile.

Par exemple :

  • Deux nœuds peuvent tenter de mettre à jour la même donnée simultanément.
  • Les délais réseau peuvent amener des nœuds à être temporairement en désaccord sur l'état courant.
  • Un nœud peut s'arrêter brutalement après n'avoir exécuté qu'une partie d'une opération.

Concevoir des systèmes qui maintiennent un état cohérent malgré ces scénarios exige une coordination minutieuse.


Briques fondamentales des systèmes distribués​

La plupart des systèmes distribués reposent sur quelques primitives essentielles.

Comprendre ces primitives aide les développeurs à concevoir des architectures fiables.


Le stockage distribué​

Les données doivent souvent être stockées sur plusieurs machines.

Cela permet :

  • la mise à l'échelle horizontale
  • la tolérance aux pannes
  • la haute disponibilité

Les stores clé-valeur distribués sont couramment utilisés à cette fin.


La coordination​

Les nœuds doivent coordonner des actions telles que :

  • l'élection de leader
  • le verrouillage distribué
  • l'appartenance au cluster
  • les mises à jour de configuration

Sans mécanismes de coordination, plusieurs nœuds pourraient tenter des opérations conflictuelles.


Le consensus​

Certains systèmes exigent de fortes garanties sur l'état partagé.

Les algorithmes de consensus tels que Raft ou Paxos permettent aux nœuds de s'accorder sur des décisions même en présence de défaillances.

Ces algorithmes sont fondamentaux pour les bases de données distribuées et les services de coordination.


Le partitionnement et la réplication​

Les données sont généralement :

  • partitionnées entre les nœuds pour répartir la charge
  • répliquées pour se protéger contre les défaillances

Équilibrer performance, disponibilité et cohérence est l'un des défis de conception fondamentaux.


Modèles courants des systèmes distribués​

Plusieurs modèles reviennent régulièrement dans les systèmes réels.

En voici quelques exemples :

  • L'élection de leader pour coordonner les activités du cluster
  • Les verrous distribués pour garantir l'exclusion mutuelle
  • Les files de tâches pour le traitement asynchrone
  • Les limiteurs de débit pour contrôler le volume de requêtes
  • Les protocoles de transaction pour les mises à jour atomiques multi-nœuds

Ces modèles constituent le socle de nombreuses plateformes à grande échelle.


Le rôle des systèmes de coordination​

Pour simplifier le développement distribué, de nombreuses organisations s'appuient sur des systèmes de coordination tels que :

  • etcd
  • ZooKeeper
  • Consul

Ces systèmes fournissent des primitives telles que :

  • l'élection de leader
  • les verrous distribués
  • l'appartenance au cluster
  • le stockage de configuration

Les applications peuvent alors construire des comportements de plus haut niveau par-dessus ces primitives.


Les systèmes distribués dans l'écosystème .NET​

Bien que les outils d'infrastructure distribuée soient souvent associés à d'autres écosystèmes, les applications .NET opèrent de plus en plus dans des environnements distribués.

Les systèmes .NET modernes utilisent fréquemment :

  • Kubernetes
  • des caches distribués
  • des microservices
  • des architectures pilotées par les événements

En conséquence, la coordination et la gestion de l'état distribué deviennent de plus en plus importantes pour les développeurs .NET également.


En conclusion​

Concevoir des systèmes distribués est fondamentalement différent de concevoir des applications mono-machine traditionnelles.

Les défis de la communication réseau, des défaillances partielles et de la cohérence des données introduisent des complexités qui exigent des modèles et une infrastructure spécialisés.

Heureusement, en comprenant les briques fondamentales — stockage, coordination, consensus et réplication — les développeurs peuvent concevoir des systèmes qui montent en charge de façon fiable et restent résilients face aux défaillances.

Dans de prochains articles, nous explorerons certaines de ces primitives plus en détail, notamment l'élection de leader, les modèles de coordination distribuée et les implémentations pratiques en .NET.