Verteilte Systeme entwickeln

Ein praktischer Leitfaden für .NET-Entwickler
Einleitung
Die meisten Backend-Systeme beginnen ihr Leben auf einem einzelnen Rechner.
Eine ASP.NET-Core-Anwendung verarbeitet Requests, eine Datenbank speichert die Anwendungsdaten, und Hintergrundprozesse übernehmen asynchrone Aufgaben wie den Versand von E-Mails oder die Erstellung von Berichten. In dieser Umgebung ist Nebenläufigkeit beherrschbar, und die Koordination zwischen den Komponenten ist vergleichsweise einfach.
Wächst das System jedoch, ändert sich das.
Der Traffic nimmt zu, mehr Anwendungsinstanzen werden hinter einem Load Balancer betrieben, und Dienste laufen auf mehreren Rechnern. Aus der einstigen Einzelanwendung wird ein verteiltes System.
An diesem Punkt ändert sich die Natur des Problems grundlegend.
Die Herausforderungen beschränken sich nicht mehr darauf, korrekte Geschäftslogik zu schreiben. Entwickler müssen sich nun mit der Koordination über Rechnergrenzen hinweg, mit Netzwerkausfällen, Teilausfällen und der Wahrung der Konsistenz über verteilten Zustand befassen.
Hier beginnt die Ingenieurdisziplin der verteilten Systeme.
Was ist ein verteiltes System?
Ein verteiltes System ist eine Menge unabhängiger Computer, die dem Benutzer als ein einziges, in sich geschlossenes System erscheinen.
Statt die gesamte Logik auf einem Rechner auszuführen, werden Verantwortlichkeiten auf mehrere Nodes verteilt, die über das Netzwerk kommunizieren.
Beispiele sind:
- Microservice-Architekturen
- Verteilte Datenbanken
- Geclusterte Caches
- Message Queues
- Cloud-Infrastrukturplattformen
Diese Systeme bieten Skalierbarkeit und Ausfallsicherheit, bringen aber neue Komplexität mit sich.
Warum verteilte Systeme schwierig sind
Anders als eine Anwendung auf einem einzelnen Rechner müssen verteilte Systeme mit Gegebenheiten wie den folgenden umgehen:
Netzwerkausfälle
In verteilten Systemen findet die Kommunikation über ein Netzwerk statt. Netzwerke können langsam, unzuverlässig oder zeitweise nicht verfügbar sein.
Ein Request kann fehlschlagen, weil der entfernte Node abgestürzt ist, weil das Netzwerk Pakete verworfen hat oder weil ein Timeout aufgetreten ist.
Das System muss solche Szenarien kontrolliert abfangen.
Teilausfälle
In einem verteilten System können Komponenten unabhängig voneinander ausfallen.
Ein Node in einem Cluster kann abstürzen, während die anderen gesund bleiben. Eine Dienstinstanz kann neu starten, während andere Dienste weiterlaufen.
Das bedeutet, dass das System auch dann korrekt arbeiten muss, wenn nur ein Teil davon funktioniert.
Herausforderungen bei der Konsistenz
Werden Daten über mehrere Nodes hinweg repliziert, wird es schwierig, sie konsistent zu halten.
Zum Beispiel:
- Zwei Nodes können versuchen, dieselben Daten gleichzeitig zu aktualisieren.
- Netzwerkverzögerungen können dazu führen, dass sich Nodes vorübergehend nicht über den aktuellen Zustand einig sind.
- Ein Node kann abstürzen, nachdem er nur einen Teil einer Operation ausgeführt hat.
Systeme, die trotz dieser Szenarien einen konsistenten Zustand wahren, erfordern eine sorgfältige Koordination.
Zentrale Bausteine verteilter Systeme
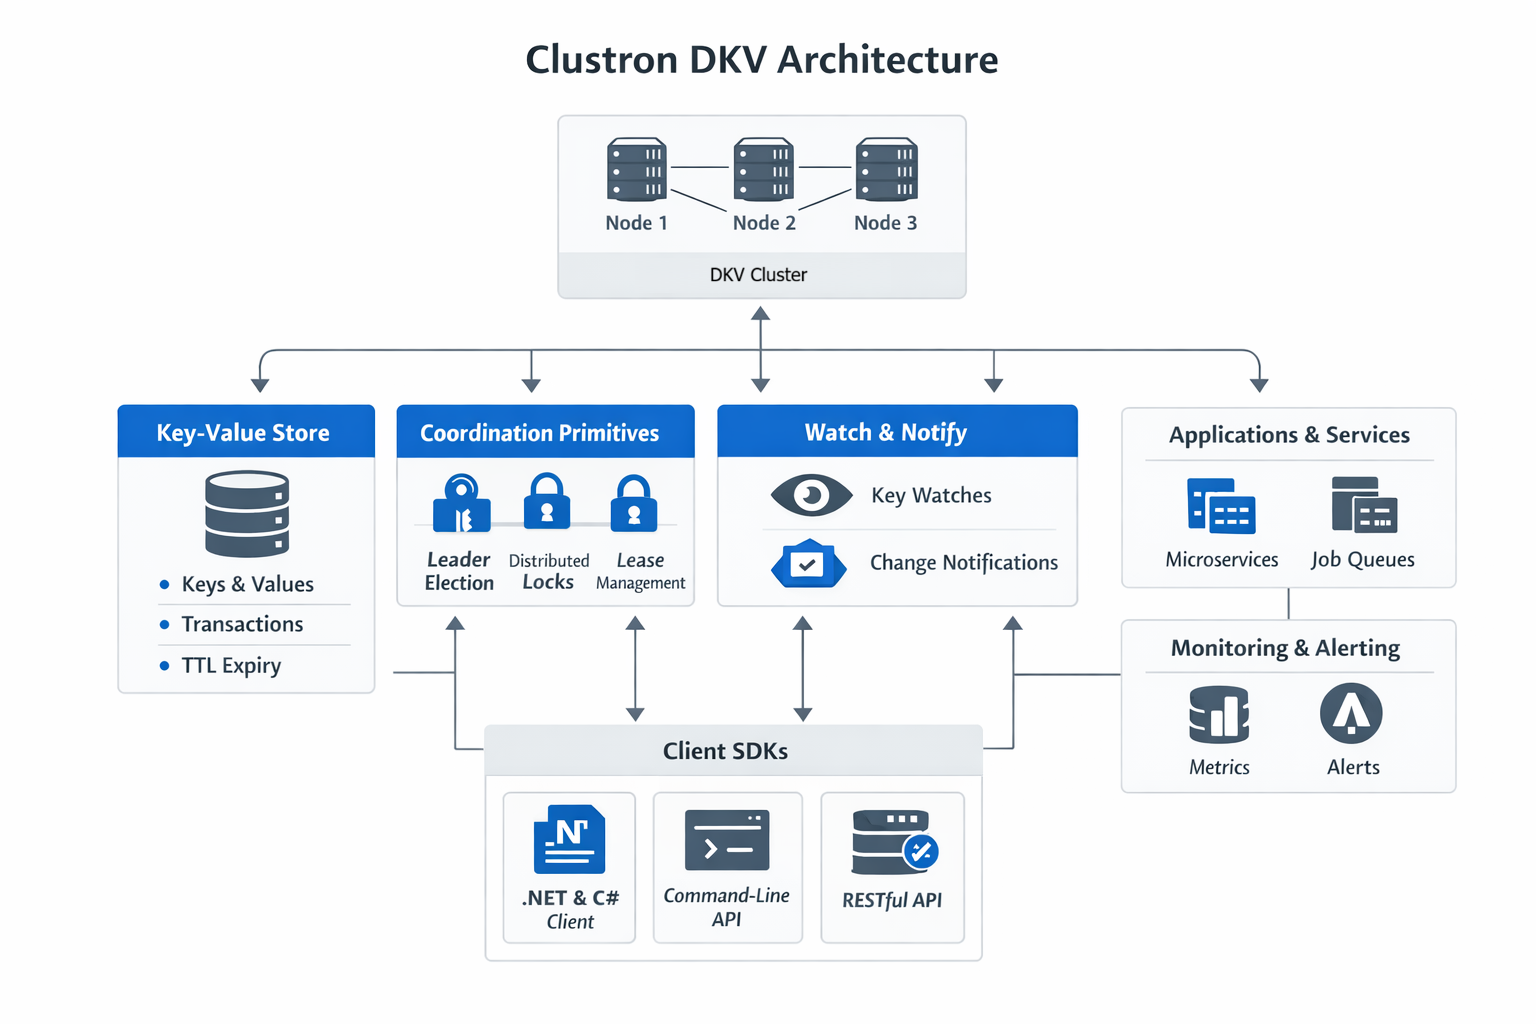
Die meisten verteilten Systeme stützen sich auf einige wenige Kernprimitive.
Wer diese Primitive versteht, kann zuverlässige Architekturen besser entwerfen.
Verteilter Speicher
Daten müssen häufig auf mehrere Rechner verteilt gespeichert werden.
Das ermöglicht:
- horizontale Skalierung
- Fehlertoleranz
- Hochverfügbarkeit
Hierfür werden üblicherweise verteilte Key/Value-Stores eingesetzt.
Koordination
Nodes müssen Aktionen wie die folgenden koordinieren:
- Leader-Election
- verteiltes Locking
- Cluster-Mitgliedschaft
- Konfigurationsänderungen
Ohne Koordinationsmechanismen könnten mehrere Nodes widersprüchliche Operationen ausführen.
Konsens
Manche Systeme benötigen starke Garantien für den gemeinsamen Zustand.
Konsensalgorithmen wie Raft oder Paxos ermöglichen es Nodes, sich auch bei Ausfällen auf Entscheidungen zu einigen.
Diese Algorithmen sind grundlegend für verteilte Datenbanken und Koordinationsdienste.
Partitionierung und Replikation
Daten werden typischerweise:
- über Nodes hinweg partitioniert, um die Last zu verteilen
- repliziert, um sich gegen Ausfälle abzusichern
Performance, Verfügbarkeit und Konsistenz auszubalancieren, ist eine der zentralen Entwurfsherausforderungen.
Gängige Muster verteilter Systeme
Mehrere Muster tauchen in realen Systemen immer wieder auf.
Beispiele:
- Leader-Election zur Koordination von Cluster-Aktivitäten
- Verteilte Locks zur Sicherstellung des gegenseitigen Ausschlusses
- Job-Queues für die asynchrone Verarbeitung
- Rate Limiter zur Steuerung des Request-Volumens
- Transaktionsprotokolle für atomare Aktualisierungen über mehrere Nodes
Diese Muster bilden das Fundament vieler großer Plattformen.
Die Rolle von Koordinationssystemen
Um die Entwicklung verteilter Systeme zu vereinfachen, setzen viele Organisationen auf Koordinationssysteme wie:
- etcd
- ZooKeeper
- Consul
Diese Systeme stellen Primitive bereit wie:
- Leader-Election
- verteilte Locks
- Cluster-Mitgliedschaft
- Konfigurationsspeicher
Anwendungen können darauf aufbauend Verhalten auf höherer Ebene umsetzen.
Verteilte Systeme im .NET-Ökosystem
Während verteilte Infrastrukturwerkzeuge oft mit anderen Ökosystemen in Verbindung gebracht werden, laufen .NET-Anwendungen zunehmend in verteilten Umgebungen.
Moderne .NET-Systeme nutzen häufig:
- Kubernetes
- verteilte Caches
- Microservices
- ereignisgesteuerte Architekturen
Dadurch gewinnen Koordination und die Verwaltung von verteiltem Zustand auch für .NET-Entwickler zunehmend an Bedeutung.
Schlussgedanken
Verteilte Systeme zu bauen, unterscheidet sich grundlegend vom Bau klassischer Anwendungen auf einem einzelnen Rechner.
Netzwerkkommunikation, Teilausfälle und Datenkonsistenz bringen Komplexität mit sich, die spezialisierte Muster und Infrastruktur erfordert.
Wer die zentralen Bausteine versteht — Speicher, Koordination, Konsens und Replikation —, kann glücklicherweise Systeme entwerfen, die zuverlässig skalieren und auch bei Ausfällen widerstandsfähig bleiben.
In kommenden Artikeln beleuchten wir einige dieser Primitive genauer, darunter Leader-Election, Koordinationsmuster für verteilte Systeme und praktische Implementierungen in .NET.