Aller au contenu principal

19 articles tagués avec « .NET »

Développement de systèmes distribués et d'infrastructure en .NET.

Voir tous les tags

Une seule chaîne de connexion, n'importe quelle plateforme : se connecter à Zaris

· 6 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Une seule chaîne de connexion pour la configuration .NET, PowerShell et la console web

La moitié des bugs de connexion « fonctionne en développement, casse en production » se résument à la même chose : les détails de connexion ont été orthographiés de trois façons différentes à trois endroits différents. Le appsettings.json avait une liste d'hôtes, le runbook d'exploitation en a collé une autre dans une session PowerShell, et la chaîne copiée d'un wiki avait un token périmé incrusté en dur.

Zaris élimine toute cette catégorie de problèmes avec un format de chaîne de connexion unique et indépendant de la plateforme. La même chaîne exacte fonctionne quand votre application .NET la lit depuis la configuration, quand un opérateur la passe à une cmdlet PowerShell, et quand quelqu'un la copie directement depuis la console web. Une orthographe canonique, partout.

Cet article décompose la chaîne partie par partie, montre les trois façons de l'utiliser, et plaide pour la seule règle qui compte le plus en production : ne jamais mettre un token brut dans la chaîne.

Des structures de données qui se répliquent : hashes, listes, sets et sorted sets dans Zaris

· 7 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Hashes, listes, sets et sorted sets natifs, répliqués comme toute autre clé dans Zaris

Zaris 1.x stockait des valeurs. Zaris 2.0.0 stocke des collections. Les hashes, listes, sets et sorted sets sont désormais des types de premier ordre, côté serveur, assortis de véritables API .NET typées — et, tout aussi important, ils se comportent comme tout le reste dans le store.

C'est cette dernière partie que l'on se représente généralement de travers. Dans beaucoup de systèmes, les « structures de données » sont une illusion côté client : une bibliothèque sérialise un dictionnaire en un blob, le Put, et appelle cela un hash. Cela fonctionne jusqu'à ce que deux clients touchent la même collection en même temps, ou jusqu'à ce que vous demandiez ce qui se passe lors d'un basculement. Dans Zaris, un hash est un hash sur le serveur. Il réside sur la partition propriétaire de sa clé, il se réplique vers le réplica de cette partition, et il survit à la perte d'un nœud exactement comme le fait une simple clé.

Zaris 2.0.0 : structures de données natives, Streams et un front-end protocole-Redis

· 8 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Zaris 2.0.0 — Structures de données natives, Streams et un front-end protocole-Redis

Aujourd'hui, nous publions Zaris 2.0.0 — la plus importante version depuis que Zaris a atteint la disponibilité générale, et la première avec un changement de version majeure. Elle transforme Zaris, qui était un store clé-valeur rapide et répliqué, en un serveur de structures de données complet : hashes, listes, sets, sorted sets, pub/sub et Redis Streams natifs, tous partitionnés et répliqués de la même façon que le sont déjà vos clés.

Et elle ouvre la porte à tous les autres. Chaque nœud peut désormais exposer un front-end protocole-Redis (RESP), de sorte qu'une application en Python, Ruby, Java, Go — n'importe quel langage disposant d'un client Redis — peut pointer vers Zaris et l'utiliser en remplacement direct, sans SDK natif et sans réécrire une ligne.

Le numéro de version est un 2, et non un 1.x, pour une raison : la 2.0.0 modifie le protocole filaire. Lisez la note de mise à niveau ci-dessous avant de la déployer.

N'importe quel langage, un seul store : comment Zaris parle le protocole Redis

· 8 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

N'importe quel langage, un seul store

Zaris est un store clé-valeur distribué conçu nativement pour .NET. Ses clients de premier ordre parlent un protocole binaire efficace, et si votre pile est en .NET, c'est le chemin que vous voulez — de véritables API asynchrones, des types .NET, des primitives de coordination, des remplacements directs IDistributedCache et HybridCache.

Mais la plupart des systèmes ne sont pas uniquement en .NET. Il y a un service Python qui fait du traitement de données, un sidecar Go, un exécuteur de tâches Ruby, une passerelle Node. Les réécrire tous vers un nouveau client pour essayer un nouveau store est inenvisageable. Aussi, dans la 2.0.0, chaque nœud Zaris peut également exposer un listener protocole-Redis (RESP2) : pointez un client Redis existant vers lui et utilisez Zaris comme store clé-valeur en remplacement direct, dans n'importe quel langage, sans changer une ligne de code client.

Cet article explique comment ce front-end fonctionne réellement — le modèle de routage, le modèle de données, les modèles de basculement, et exactement quelles commandes sont prises en charge ou non.

Des lectures qui montent en charge avec vos cœurs

· 6 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Le débit GET de Zaris monte en charge avec les cœurs

Redis est rapide. Il est aussi, par conception, mono-thread sur le chemin de données : une boucle d'événements, un cœur, une commande à la fois. C'est une conception réellement bonne — elle rend Redis simple à appréhender et élimine toute une catégorie de bugs de concurrence. Mais elle comporte un plafond qu'aucune somme d'argent ne peut lever. Donnez à un moteur mono-boucle d'événements une machine à 4 cœurs, à 8 cœurs, à 32 cœurs, et le débit en lecture retombe au même endroit. Les cœurs supplémentaires restent inactifs.

Zaris emprunte l'autre voie. Les clés sont partitionnées et chaque partition a un propriétaire, de sorte que les lectures de clés différentes atterrissent sur des cœurs différents et s'exécutent en même temps. Résultat : un débit qui bouge lorsque vous ajoutez des cœurs — une pente plutôt qu'une ligne plate.

Vous venez de Redis : pointer votre application .NET vers Zaris

· 6 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Deux chemins de Redis vers Zaris

Si vos services .NET communiquent déjà avec Redis, passer à Zaris n'a pas à être une réécriture. Zaris est un store clé-valeur distribué, en mémoire et répliqué, conçu nativement pour .NET — et depuis la 2.0.0, il parle deux protocoles à la fois : son propre protocole binaire efficace pour les clients .NET de premier ordre, et un front-end RESP2 compatible Redis que n'importe quel client Redis, dans n'importe quel langage, peut viser.

Cela vous offre deux chemins de migration honnêtes, qui ne s'excluent pas mutuellement. Vous pouvez commencer par le chemin RESP sans aucune modification pour mettre Zaris sous charge dès aujourd'hui, puis adopter le client natif là où cela est rentable. Cet article parcourt les deux et vous donne une règle claire pour choisir.

Zaris 0.9.0 est là — et disponible en disponibilité générale

· 5 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Zaris 0.9.0 — Disponibilité générale

Aujourd'hui, nous publions Zaris 0.9.0, et avec lui, Zaris atteint la disponibilité générale. Il est prêt pour la production, multiplateforme, et désormais soutenu par un support commercial.

Si vous ne le connaissez pas encore : Zaris est un store clé-valeur distribué et en mémoire pour .NET. Il est rapide, répliqué, et vous pouvez le piloter depuis un navigateur, PowerShell, ou directement depuis votre application. Cette version est l'aboutissement de ce travail — le moment où un « projet prometteur » devient une « solution que vous pouvez mettre en production ».

Les verrous distribués expliqués

· 5 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Un guide pratique pour les développeurs .NET

Introduction​

À mesure que les applications montent en charge sur plusieurs machines, la coordination devient l'un des aspects les plus délicats de la conception des systèmes.

Dans une application mono-machine, l'exclusion mutuelle est simple. Les développeurs peuvent s'appuyer sur des primitives du langage telles que lock en C#, Mutex ou Semaphore pour garantir qu'un seul thread accède à une ressource partagée à la fois.

Cependant, ces primitives ne fonctionnent qu'au sein d'un seul processus ou d'une seule machine.

Dès lors que les applications s'exécutent sur plusieurs services ou nœuds, les mécanismes de verrouillage traditionnels ne fonctionnent plus. Deux services s'exécutant sur des machines différentes ne peuvent pas s'appuyer sur une instruction lock locale pour coordonner l'accès à un état partagé.

C'est ici que les verrous distribués deviennent essentiels.

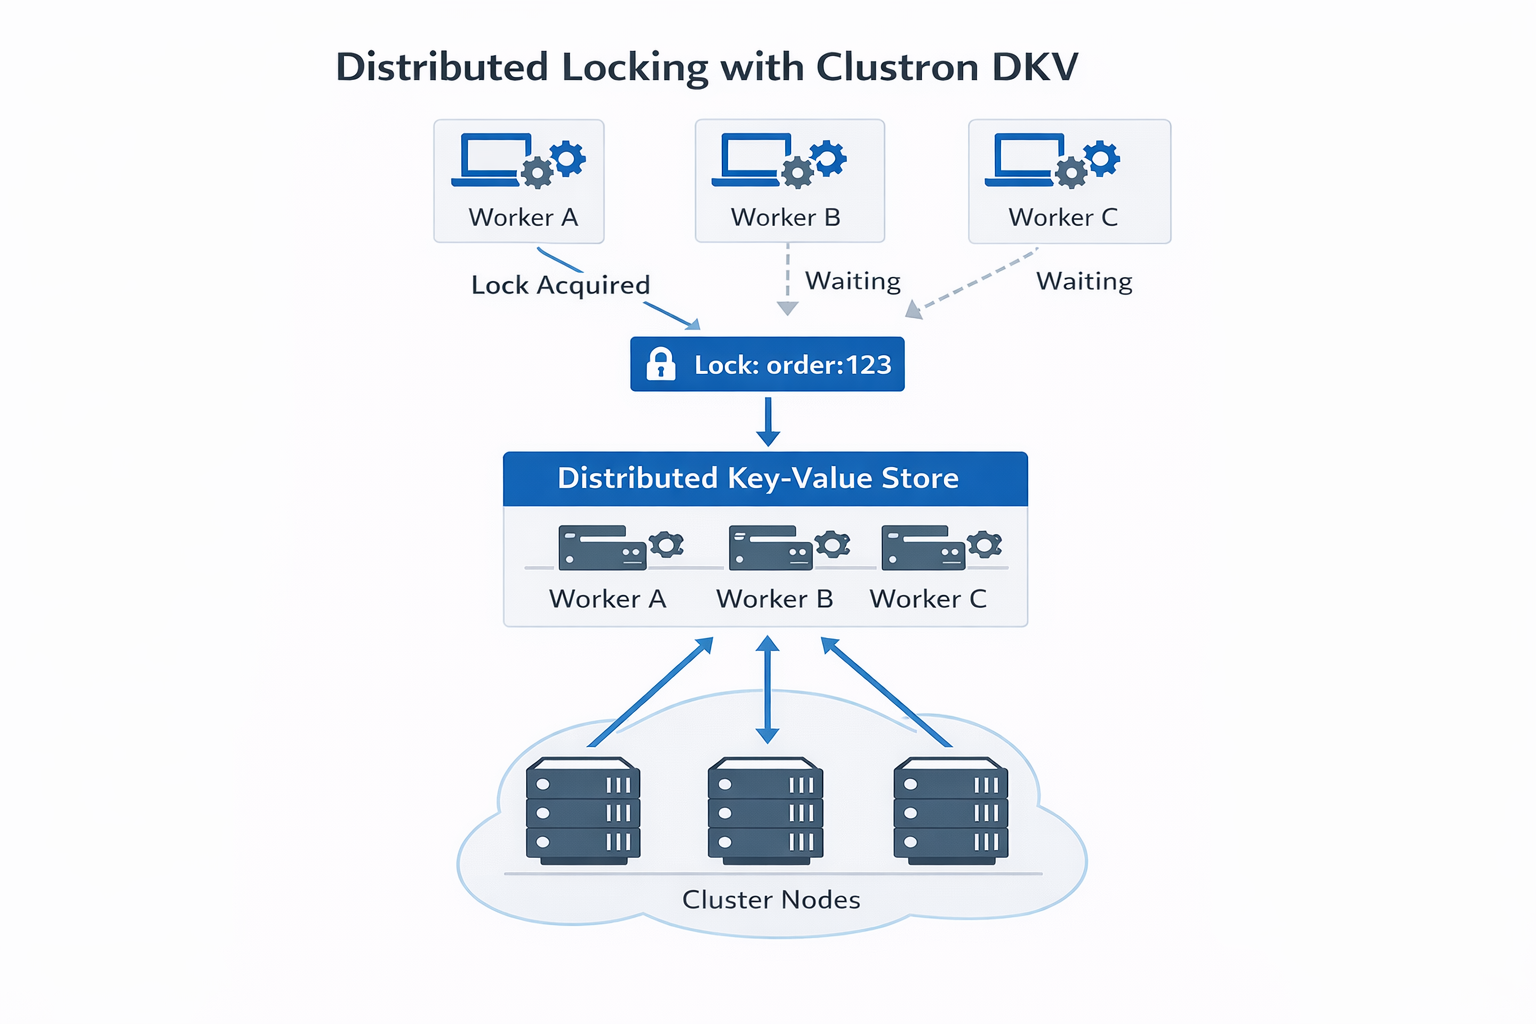
Les verrous distribués permettent aux services répartis sur un cluster de coordonner l'accès aux ressources partagées tout en garantissant qu'un seul participant détient le verrou à un instant donné.


Verrous locaux vs verrous distribués​

Un verrou local typique en C# ressemble à ceci :

private static readonly object _lock = new object();

public void ProcessOrder()
{
lock(_lock)
{
Console.WriteLine("Processing order safely.");
}
}

Cela fonctionne parfaitement à l'intérieur d'un seul processus.

Cependant, si votre application s'exécute sur plusieurs instances de service, chaque instance possède son propre objet _lock. Le verrou ne coordonne plus le travail à l'échelle du système.

Worker A → lock acquired Worker B → lock acquired Worker C → lock acquired

Tous les workers progressent simultanément, ce qui annule l'intérêt du verrouillage.

Les systèmes distribués nécessitent un mécanisme de coordination partagé.


Verrouillage distribué


L'idée derrière les verrous distribués​

Un verrou distribué utilise un système partagé pour représenter la possession du verrou.

Au lieu de verrouiller la mémoire, un nœud enregistre la possession du verrou dans un système de coordination distribué tel que :

  • un store clé-valeur distribué
  • un service de coordination
  • un cache distribué

Concept d'exemple :

Lock Key: order:123 Owner: worker‑1

Si un autre worker tente d'acquérir le même verrou, l'opération échoue jusqu'à ce que le verrou soit libéré ou expire.


Scénario concret : traitement distribué de factures​

Imaginez un cluster de workers traitant des factures.

Worker A Worker B Worker C

Tous les workers recherchent les factures en attente.

Sans verrouillage :

Worker A → processes invoice #101 Worker B → processes invoice #101 Worker C → processes invoice #101

La même facture pourrait être traitée plusieurs fois.

Un verrou distribué garantit qu'un seul worker traite la facture.


Les verrous distribués avec Clustron DKV​

Clustron DKV fournit des primitives intégrées pour la coordination distribuée.

Les verrous sont gérés via l'API Locks, et les opérations sur les clés verrouillées doivent inclure le bon handle de verrou.


Acquérir un verrou​

Un client acquiert d'abord un verrou pour une clé spécifique.

var locks = ((IDkv)client).Locks;

var key = "order:123";

var lockHandle = await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

if (lockHandle == null)
{
Console.WriteLine("Failed to acquire lock.");
return;
}

Console.WriteLine("Lock acquired.");

Le handle de verrou renvoyé représente la possession du verrou.


Effectuer des opérations sous le verrou​

Une fois un verrou acquis, les opérations doivent inclure le handle de verrou.

var result = await client.PutAsync(
key,
"processed",
Put.WithLock(lockHandle.Handle));

if (result.IsSuccess)
{
Console.WriteLine("Value updated safely.");
}

Seul le propriétaire du verrou peut modifier la valeur.


Lire avec le verrou​

Les lectures peuvent elles aussi respecter la possession du verrou.

var value = await client.GetAsync<string>(
key,
Get.WithLock(lockHandle.Handle));

if (value.IsSuccess)
{
Console.WriteLine($"Value: {value.Value}");
}

Opérations concurrentes sans le verrou​

Si un autre worker tente de modifier la clé sans le verrou, l'opération échoue.

var attempt = await client.PutAsync(key, "new-value");

if (!attempt.IsSuccess)
{
Console.WriteLine($"Operation rejected: {attempt.Status}");
}

Résultat :

KvStatus.Locked

Cela empêche la modification concurrente de la même ressource.


Libérer le verrou​

Une fois le travail terminé, le verrou peut être libéré.

await lockHandle.ReleaseAsync();

Console.WriteLine("Lock released.");

Après la libération du verrou, un autre worker peut l'acquérir.


Exemple de workflow de cluster​

Worker A → Acquire Lock → Success Worker B → Acquire Lock → Failed Worker C → Acquire Lock → Failed

Worker A → Update Key Worker A → Release Lock

Un seul worker effectue l'opération, garantissant la correction.


Gérer les défaillances​

Les verrous dans Clustron sont bornés dans le temps.

Lors de l'acquisition d'un verrou, une durée doit être spécifiée :

await locks.AcquireAsync(key, TimeSpan.FromSeconds(10));

Si le client détenant le verrou s'arrête brutalement ou se déconnecte, le verrou finit par expirer, ce qui permet à un autre worker de l'acquérir.

Cela évite que les verrous ne restent détenus indéfiniment.


Bonnes pratiques​

Lorsque vous implémentez des verrous distribués :

  • Gardez les sections critiques courtes
  • Évitez les verrous globaux lorsque c'est possible
  • Partitionnez les verrous par ressource
  • Concevez toujours en prévoyant les scénarios de défaillance

En conclusion​

Les verrous distribués sont l'une des primitives de coordination les plus fondamentales des systèmes distribués.

Ils permettent aux services s'exécutant sur plusieurs machines de coordonner en toute sécurité l'accès aux ressources partagées tout en préservant la correction du système.

Des plateformes comme Clustron DKV simplifient cela en fournissant des primitives de verrouillage intégrées, des opérations atomiques et de fortes garanties de cohérence.

Dans le prochain article, nous explorerons une autre primitive essentielle des systèmes distribués :

l'élection de leader.

Concevoir des systèmes distribués

· 5 minutes de lecture
Clustron Team
Ingénierie des systèmes distribués

Un guide pratique pour les développeurs .NET

Introduction​

La plupart des systèmes backend commencent leur existence sur une seule machine.

Une application ASP.NET Core traite les requêtes, une base de données stocke les données applicatives et des workers d'arrière-plan gèrent les tâches asynchrones telles que l'envoi d'e-mails ou la génération de rapports. Dans cet environnement, la concurrence reste gérable et la coordination entre les composants est relativement simple.

À mesure que le système grandit, cependant, les choses commencent à changer.

Le trafic augmente, davantage d'instances applicatives sont déployées derrière un load balancer et les services s'exécutent sur plusieurs machines. Ce qui était autrefois une application unique évolue vers un système distribué.

À ce stade, la nature du problème change radicalement.

Les défis ne se limitent plus à l'écriture d'une logique métier correcte. Les développeurs doivent désormais composer avec la coordination entre machines, les pannes réseau, les défaillances partielles et le maintien de la cohérence sur un état distribué.

C'est ici que commence l'ingénierie des systèmes distribués.
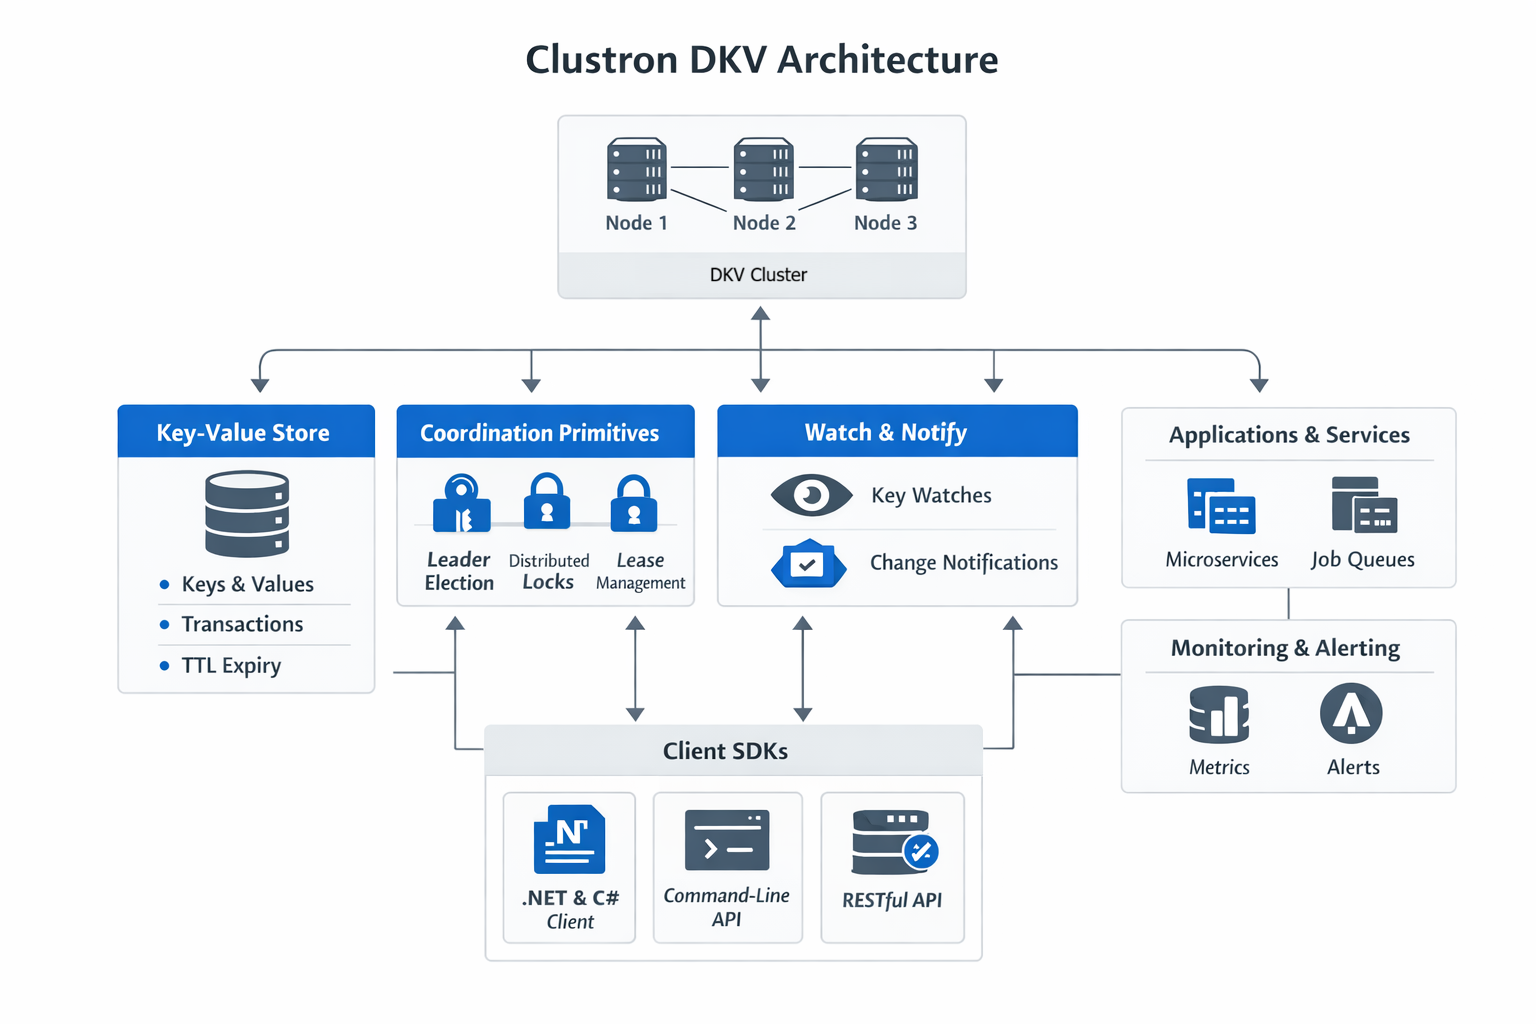

Architecture des systèmes distribués


Qu'est-ce qu'un système distribué ?​

Un système distribué est un ensemble d'ordinateurs indépendants qui apparaissent à l'utilisateur comme un système cohérent unique.

Au lieu d'exécuter toute la logique sur une seule machine, les responsabilités sont réparties sur plusieurs nœuds qui communiquent par le réseau.

En voici quelques exemples :

  • Les architectures microservices
  • Les bases de données distribuées
  • Les caches en cluster
  • Les files de messages
  • Les plateformes d'infrastructure cloud

Ces systèmes offrent évolutivité et résilience, mais introduisent de nouvelles complexités.


Pourquoi les systèmes distribués sont difficiles​

Contrairement à une application mono-machine, les systèmes distribués doivent composer avec des réalités telles que :

Les pannes réseau​

Dans les systèmes distribués, la communication passe par un réseau. Les réseaux peuvent être lents, peu fiables ou temporairement indisponibles.

Une requête peut échouer parce que le nœud distant s'est arrêté brutalement, parce que le réseau a perdu des paquets ou parce qu'un timeout s'est produit.

Le système doit gérer ces scénarios avec élégance.


Les défaillances partielles​

Dans un système distribué, les composants peuvent tomber en panne indépendamment les uns des autres.

Un nœud d'un cluster peut s'arrêter brutalement tandis que les autres restent sains. Une instance de service peut redémarrer pendant que d'autres services continuent de fonctionner.

Cela signifie que le système doit fonctionner correctement même lorsqu'une partie seulement de celui-ci est opérationnelle.


Les défis de cohérence​

Lorsque des données sont répliquées sur plusieurs nœuds, les maintenir cohérentes devient difficile.

Par exemple :

  • Deux nœuds peuvent tenter de mettre à jour la même donnée simultanément.
  • Les délais réseau peuvent amener des nœuds à être temporairement en désaccord sur l'état courant.
  • Un nœud peut s'arrêter brutalement après n'avoir exécuté qu'une partie d'une opération.

Concevoir des systèmes qui maintiennent un état cohérent malgré ces scénarios exige une coordination minutieuse.


Briques fondamentales des systèmes distribués​

La plupart des systèmes distribués reposent sur quelques primitives essentielles.

Comprendre ces primitives aide les développeurs à concevoir des architectures fiables.


Le stockage distribué​

Les données doivent souvent être stockées sur plusieurs machines.

Cela permet :

  • la mise à l'échelle horizontale
  • la tolérance aux pannes
  • la haute disponibilité

Les stores clé-valeur distribués sont couramment utilisés à cette fin.


La coordination​

Les nœuds doivent coordonner des actions telles que :

  • l'élection de leader
  • le verrouillage distribué
  • l'appartenance au cluster
  • les mises à jour de configuration

Sans mécanismes de coordination, plusieurs nœuds pourraient tenter des opérations conflictuelles.


Le consensus​

Certains systèmes exigent de fortes garanties sur l'état partagé.

Les algorithmes de consensus tels que Raft ou Paxos permettent aux nœuds de s'accorder sur des décisions même en présence de défaillances.

Ces algorithmes sont fondamentaux pour les bases de données distribuées et les services de coordination.


Le partitionnement et la réplication​

Les données sont généralement :

  • partitionnées entre les nœuds pour répartir la charge
  • répliquées pour se protéger contre les défaillances

Équilibrer performance, disponibilité et cohérence est l'un des défis de conception fondamentaux.


Modèles courants des systèmes distribués​

Plusieurs modèles reviennent régulièrement dans les systèmes réels.

En voici quelques exemples :

  • L'élection de leader pour coordonner les activités du cluster
  • Les verrous distribués pour garantir l'exclusion mutuelle
  • Les files de tâches pour le traitement asynchrone
  • Les limiteurs de débit pour contrôler le volume de requêtes
  • Les protocoles de transaction pour les mises à jour atomiques multi-nœuds

Ces modèles constituent le socle de nombreuses plateformes à grande échelle.


Le rôle des systèmes de coordination​

Pour simplifier le développement distribué, de nombreuses organisations s'appuient sur des systèmes de coordination tels que :

  • etcd
  • ZooKeeper
  • Consul

Ces systèmes fournissent des primitives telles que :

  • l'élection de leader
  • les verrous distribués
  • l'appartenance au cluster
  • le stockage de configuration

Les applications peuvent alors construire des comportements de plus haut niveau par-dessus ces primitives.


Les systèmes distribués dans l'écosystème .NET​

Bien que les outils d'infrastructure distribuée soient souvent associés à d'autres écosystèmes, les applications .NET opèrent de plus en plus dans des environnements distribués.

Les systèmes .NET modernes utilisent fréquemment :

  • Kubernetes
  • des caches distribués
  • des microservices
  • des architectures pilotées par les événements

En conséquence, la coordination et la gestion de l'état distribué deviennent de plus en plus importantes pour les développeurs .NET également.


En conclusion​

Concevoir des systèmes distribués est fondamentalement différent de concevoir des applications mono-machine traditionnelles.

Les défis de la communication réseau, des défaillances partielles et de la cohérence des données introduisent des complexités qui exigent des modèles et une infrastructure spécialisés.

Heureusement, en comprenant les briques fondamentales — stockage, coordination, consensus et réplication — les développeurs peuvent concevoir des systèmes qui montent en charge de façon fiable et restent résilients face aux défaillances.

Dans de prochains articles, nous explorerons certaines de ces primitives plus en détail, notamment l'élection de leader, les modèles de coordination distribuée et les implémentations pratiques en .NET.